
Dvě místa, kde agent selže
Agent, který má volat nástroje, může selhat nenápadně. Vybere špatný nástroj, nebo vybere správný a předá mu chybné argumenty. Návod OpenRouter proto radí testovat výběr nástroje a správnost argumentů odděleně. Nabízí tři přístupy: hodnoticí model bez reference, deterministické kontroly argumentů a porovnání trajektorie, tedy posloupnosti volání. K tomu přidává ukázkový skript v Pythonu, který lze použít jako základ vlastního testu.
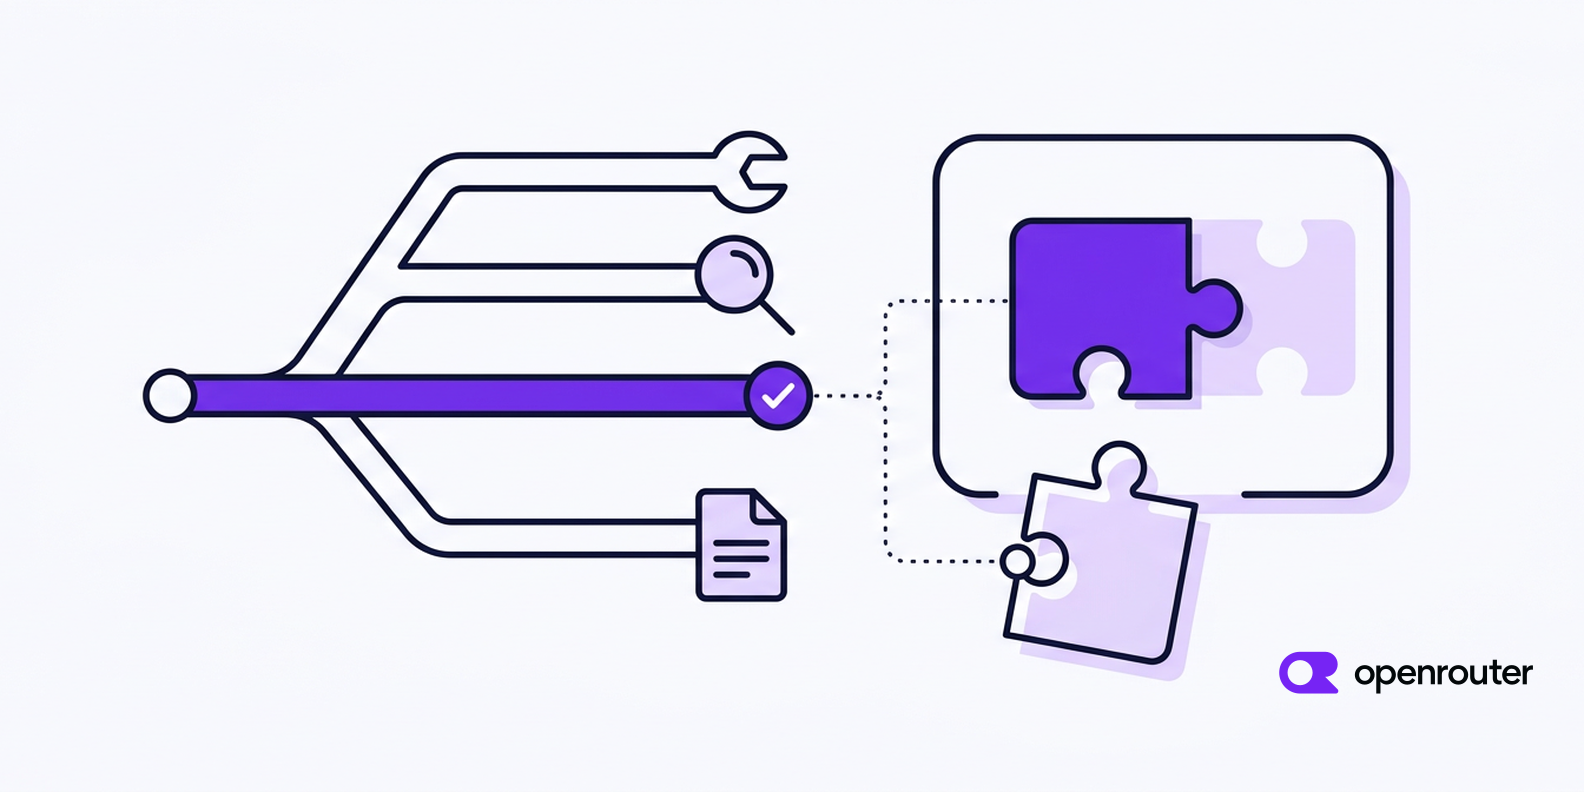
Testovací sada podle autorů nemá obsahovat jen situace, kdy je nástroj potřeba. Patří do ní i případy, kdy model už má dost informací a nástroj volat nemá. Samotná kontrola, zda odpověď obsahuje pole tool_calls, nestačí, protože i zbytečné nebo chybné volání je pořád volání. Pokud je jasně očekáván jediný nástroj, stačí v kódu porovnat jeho název s očekávaným. Když úlohu může rozumně vyřešit více nástrojů, přesná shoda může platnou volbu odmítnout. Tehdy se víc hodí hodnoticí model.
Tři způsoby kontroly
Prvním nástrojem je validace schématu JSON. Zachytí nevalidní JSON, chybějící povinná pole, špatné typy, neplatné hodnoty výčtu i parametry, které nástroj nepřijímá. Použít lze stejné schéma, které se posílá modelu. V příkladu funkce lookup_order tak odhalí chybějící order_id, text místo booleanu u include_items nebo nedeklarované pole customer_email. Schéma ale nezaručuje správný obsah. Hodnota ord_7282 schématu vyhoví, a přesto je špatně, pokud se uživatel ptal na objednávku ord_7281.
Druhou možností je hodnoticí model bez referenční odpovědi. Návod ho doporučuje tam, kde správnost závisí na kontextu nebo je platných voleb více, takže není s čím hodnotu v kódu porovnat. Takový model ale potřebuje jasné instrukce, co se považuje za správné. Při srovnávání kandidátních modelů se mají instrukce i hodnoticí model držet beze změny. Jeho rozhodnutí se má předem ověřit na malé sadě ručně prověřených případů. Pokud na stejnou otázku spolehlivě odpoví kontrola rovnosti, validátor nebo obchodní pravidlo, má se použít to.
Třetí přístup, porovnání trajektorie, se hodí tam, kde je pořadí volání součástí zadání. Vyhodnocovače LangSmith podporují přísnou, neuspořádanou, podmnožinovou a nadmnožinovou shodu. Přísná kontrola vynucuje jednu sekvenci, ostatní režimy připouštějí jiné pořadí nebo žádají jen určitou množinu volání. Vede-li k platnému výsledku více cest, nemá se vyžadovat jediná přesná sekvence. V benchmarku τ²-bench je zaznamenaný seznam akcí jednou referenční trajektorií, z níž se odvodí cílový stav databáze. Kontrolou projde každá sekvence, která skončí ekvivalentním stavem.
Ukázkový harness krok za krokem
Ukázkový harness používá OpenAI Python SDK s endpointem OpenRouter, který je s OpenAI kompatibilní. Nejdřív ověří, že se názvy vrácených nástrojů shodují s očekávanými. U případu bez očekávaných volání, například dotazu na význam stavu „shipped“, tak musí být seznam volání prázdný. Pak každé vrácené volání validuje schématem JSON Schema Draft 7. Teprve potom porovná hodnoty argumentů s očekávaným obsahem.
Harness nastavuje reasoning.effort na low pro všechny kandidáty. Rozdíl ve výchozí úrovni uvažování se tak nemá projevit jako rozdíl v přesnosti volání nástrojů. Nastavuje také provider.require_parameters na true. Požadavek pak míří jen k poskytovatelům, kteří podporují všechny jeho parametry, takže každá hodnocená odpověď vznikla se zadanou úrovní uvažování.
Poskytovatelé a skryté zdroje chyb
Podle OpenRouter běží Auto Exacto u každého požadavku s nástroji a může změnit, který endpoint poskytovatele ho obslouží. Jeho vstupem je Tool Call Error Rate, ale ta měří chování poskytovatele a lokální validaci schématu nenahrazuje. Pro srovnání na úrovni jednoho endpointu návod radí zafixovat poskytovatele polem order a nastavit allow_fallbacks na false. Max_tokens se naopak nemá nastavovat, protože zkrácená odpověď může useknout JSON volání a vypadat jako InvalidJson, ač s výběrem nástroje nesouvisí.
Co návod neřeší a kde se chybuje
Ukázkový harness hodnotí jen jedno kolo volání nástrojů. Pro reálné srovnání je proto potřeba každý případ spustit vícekrát, aby skóre modelu nestálo na jediné odpovědi. Dostupné podklady jsou praktický návod, nikoli studie. Nenabízejí naměřené výsledky konkrétních modelů, takže z nich nelze usuzovat, který z nich volá nástroje přesněji.
Mezi typické chyby návod řadí testování jen čistých požadavků, tedy bez nejasných nebo nepřesných zadání. Dále je to kontrola pouze prvního prvku tool_calls[0]. Odpověď přitom může obsahovat několik volání, a proto se má vyhodnotit celé pole. Třetí chybou je záměna platného payloadu za správný: argumenty projdou schématem, a přesto mohou mít špatnou hodnotu, jako v příkladu s objednávkou ord_7282.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- How to Test Tool-Calling Accuracy in AI Agents — OpenRouter Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.