
Agent, který spouští modely sám
Příprava vstupů, spouštění několika modelů a porovnání výsledků zabere v biologii spoustu ruční práce. NVIDIA na vývojářském blogu popisuje, jak ji zvládá agent v prostředí Claude Science. Podle firmy BioNeMo Agent Toolkit spojuje více než deset let modelů, knihoven a workflow do dovedností, které mohou agenti volat. NVIDIA s Anthropic toolkit propojily tak, že agent mikroslužby BioNeMo NIM sám najde, spustí i zavolá. NVIDIA dále tvrdí, že v interních benchmarcích dovednosti zvýšily správnost úloh ze 60 na 100 procent a zhruba zdvojnásobily efektivitu využití tokenů. Jde o údaje výrobce, nezávislé ověření text neuvádí.
Co postup vyžaduje a jak probíhá
Ukázkový postup je náročný na hardware. Potřebujete pracovní stanici nebo cloudový stroj s GPU NVIDIA L40S či H100 a nainstalovaný Claude Science. Úložiště by mělo mít zhruba 700 GB. Největší položkou je databáze UniRef30 pro službu msa-search, která zabírá asi 490 GB. Autoři použili profil jen s touto databází místo plné sady o velikosti 1,4 TB. Kontejnery modelů Boltz-2 a OpenFold3 přidají dohromady 30 až 40 GB.
Workflow má tři fáze. Nejdřív služba MSA Search NIM na GPU vytvoří zarovnání příbuzných sekvencí, tedy evoluční kontext pro cílové proteiny. Potom model OpenFold3 předpoví strukturu jednoho řetězce i komplexu dvou řetězců. Nakonec se predikce zopakují v modelu Boltz-2 a každý model se vyhodnotí nezávisle. Testovacím případem byl jaderný pórový protein Seh1 (384 reziduí) z houby Paracoccidioides lutzii a nepopsaný navrhovaný partner C1HCX1 (976 reziduí). Vyhledávání vrátilo pro každý z nich 202 sekvencí.
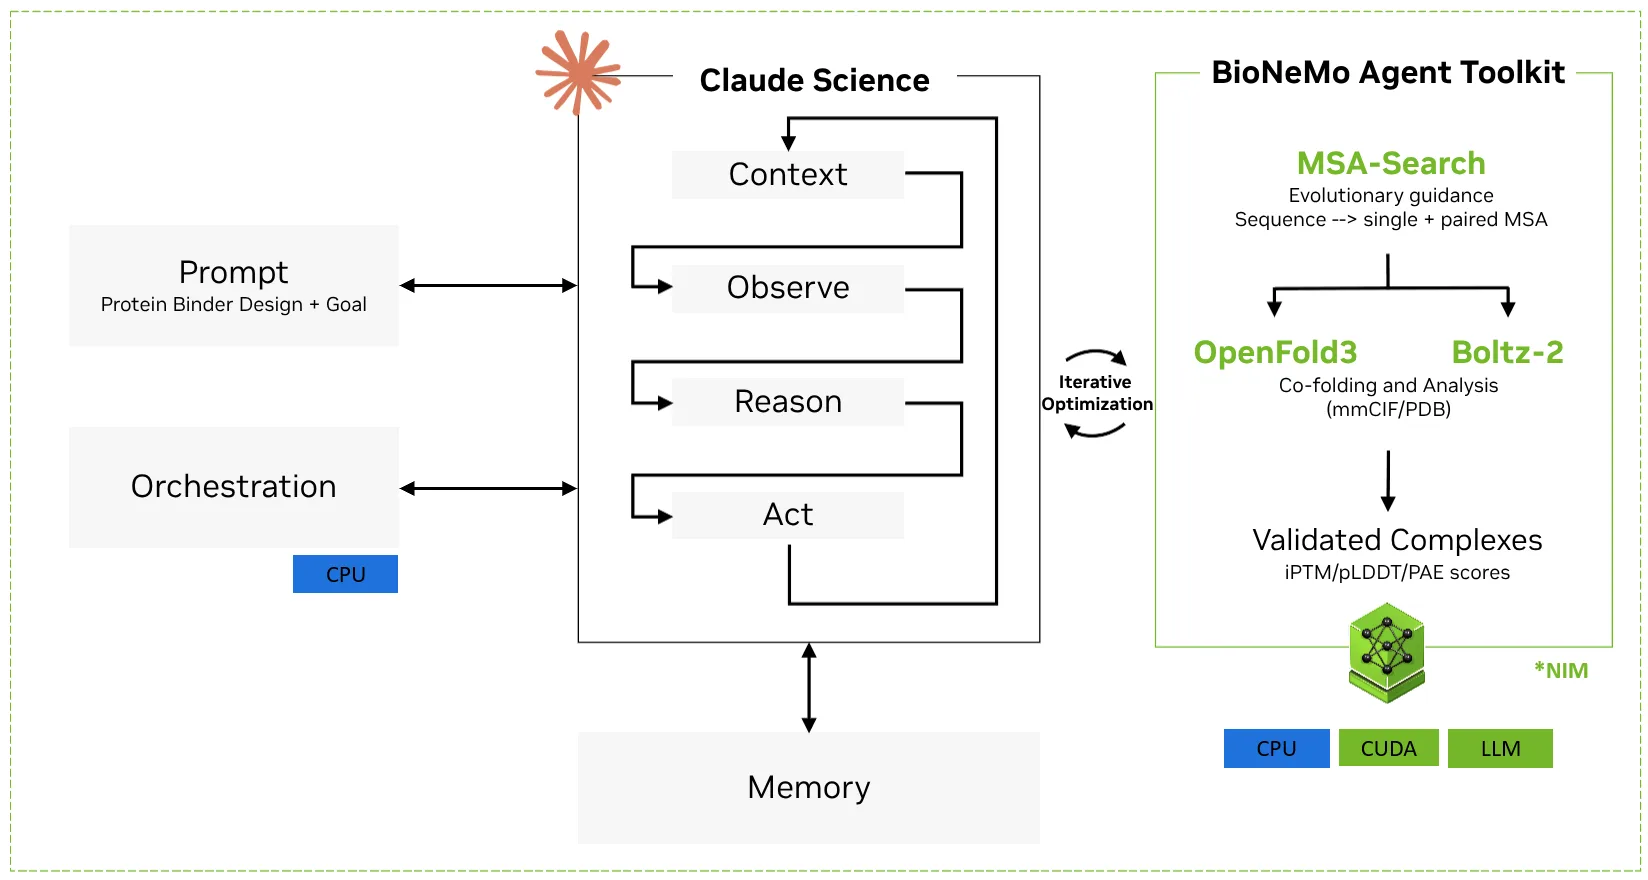
Agent vytvořil dva druhy zarovnání. Nespárované popisuje zvlášť každý řetězec. Párované vzniká spojením příbuzných verzí obou proteinů nalezených ve stejném druhu. Podle blogu platí, že když se změny v jednom proteinu soustavně shodují se změnami ve druhém, pomůže to modelům odhadnout, kde se proteiny mohou setkávat. Modely se liší i vstupy: OpenFold3 bere u komplexů zvláštní pole paired_msa, kdežto Boltz-2 takové pole nemá a řetězce páruje interně. Každý jeho řetězec proto dostal vlastní soubor A3M.
Bez evoluční informace rozhraní mizí
Protože workflow spustil i predikce bez zarovnání, šlo přímo změřit, kolik vstup přináší. Autoři sledovali metriku iPTM, která vyjadřuje, jak jistě model odhaduje kontakt mezi dvěma řetězci. S zarovnáním dosáhla 0,85 u OpenFold3 a 0,82 u Boltz-2. Bez něj klesla na 0,14 a 0,19. Pět vzorků na každou podmínku se těsně shlukovalo (směrodatná odchylka nejvýše 0,006), takže rozdíl byl konzistentní.
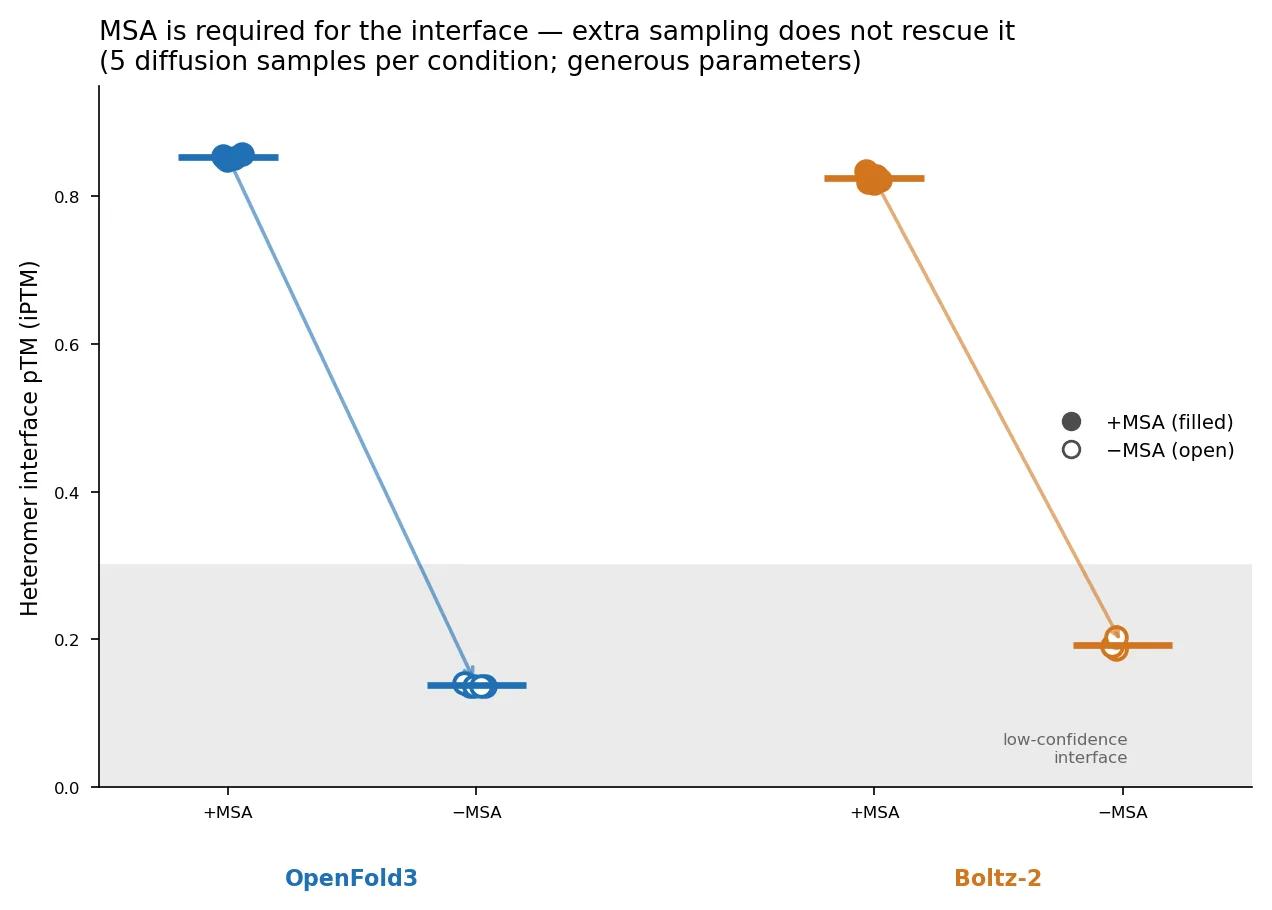
Dalo by se namítnout, že modely jen málo vzorkovaly. Autoři proto zvýšili rozpočet: OpenFold3 pět difuzních vzorků, Boltz-2 pět vzorků se šesti recyklacemi a 200 kroky vzorkování. Obraz se nezměnil. Rozhraní zůstalo s zarovnáním vysoké a bez něj kleslo, přičemž hodnoty se lišily o méně než 0,01 iPTM od jednoho vzorku. Podle autorů tedy další vzorkování evoluční vstup nenahradí. Modely navíc, přestože mají odlišnou architekturu, dospěly při použití zarovnání ke hodnotám lišícím se o 0,03 iPTM.
Samotný protein Seh1 reaguje na chybějící zarovnání podle modelu odlišně. Metrika pLDDT, která u jednoho řetězce vyjadřuje jistotu modelu, klesla u OpenFold3 z 82 na 36, takže bez zarovnání nezvládl složit ani jediný řetězec. Boltz-2 si vedl lépe: hodnota se změnila z 0,79 na 0,73, monomer tedy z pouhé sekvence složil poměrně dobře. Rozhraní mezi řetězci ale bez zarovnání neumístil ani on. Zdroj uvádí obě čísla v odlišném zápisu, proto je nelze bez dalšího přímo porovnávat.
Co ukázala předpovězená struktura
Agent také zkoumal, zda partner mění předpovězenou skladbu Seh1. Po superpozici monomeru a heteromeru vyšla core Cα-RMSD, tedy míra odchylky jádra obou struktur, na 0,68 Å u OpenFold3 a 0,65 Å u Boltz-2. Podle autorů partner existující β-propeler doplňuje, nepřestavuje ho. Oba modely nezávisle umístily shluk β-řetězců C1HCX1 (zhruba zbytky 305–391) k Seh1 na místo uzávěru WD40 typu velcro, což odpovídá pozorování ve zdrojové studii.
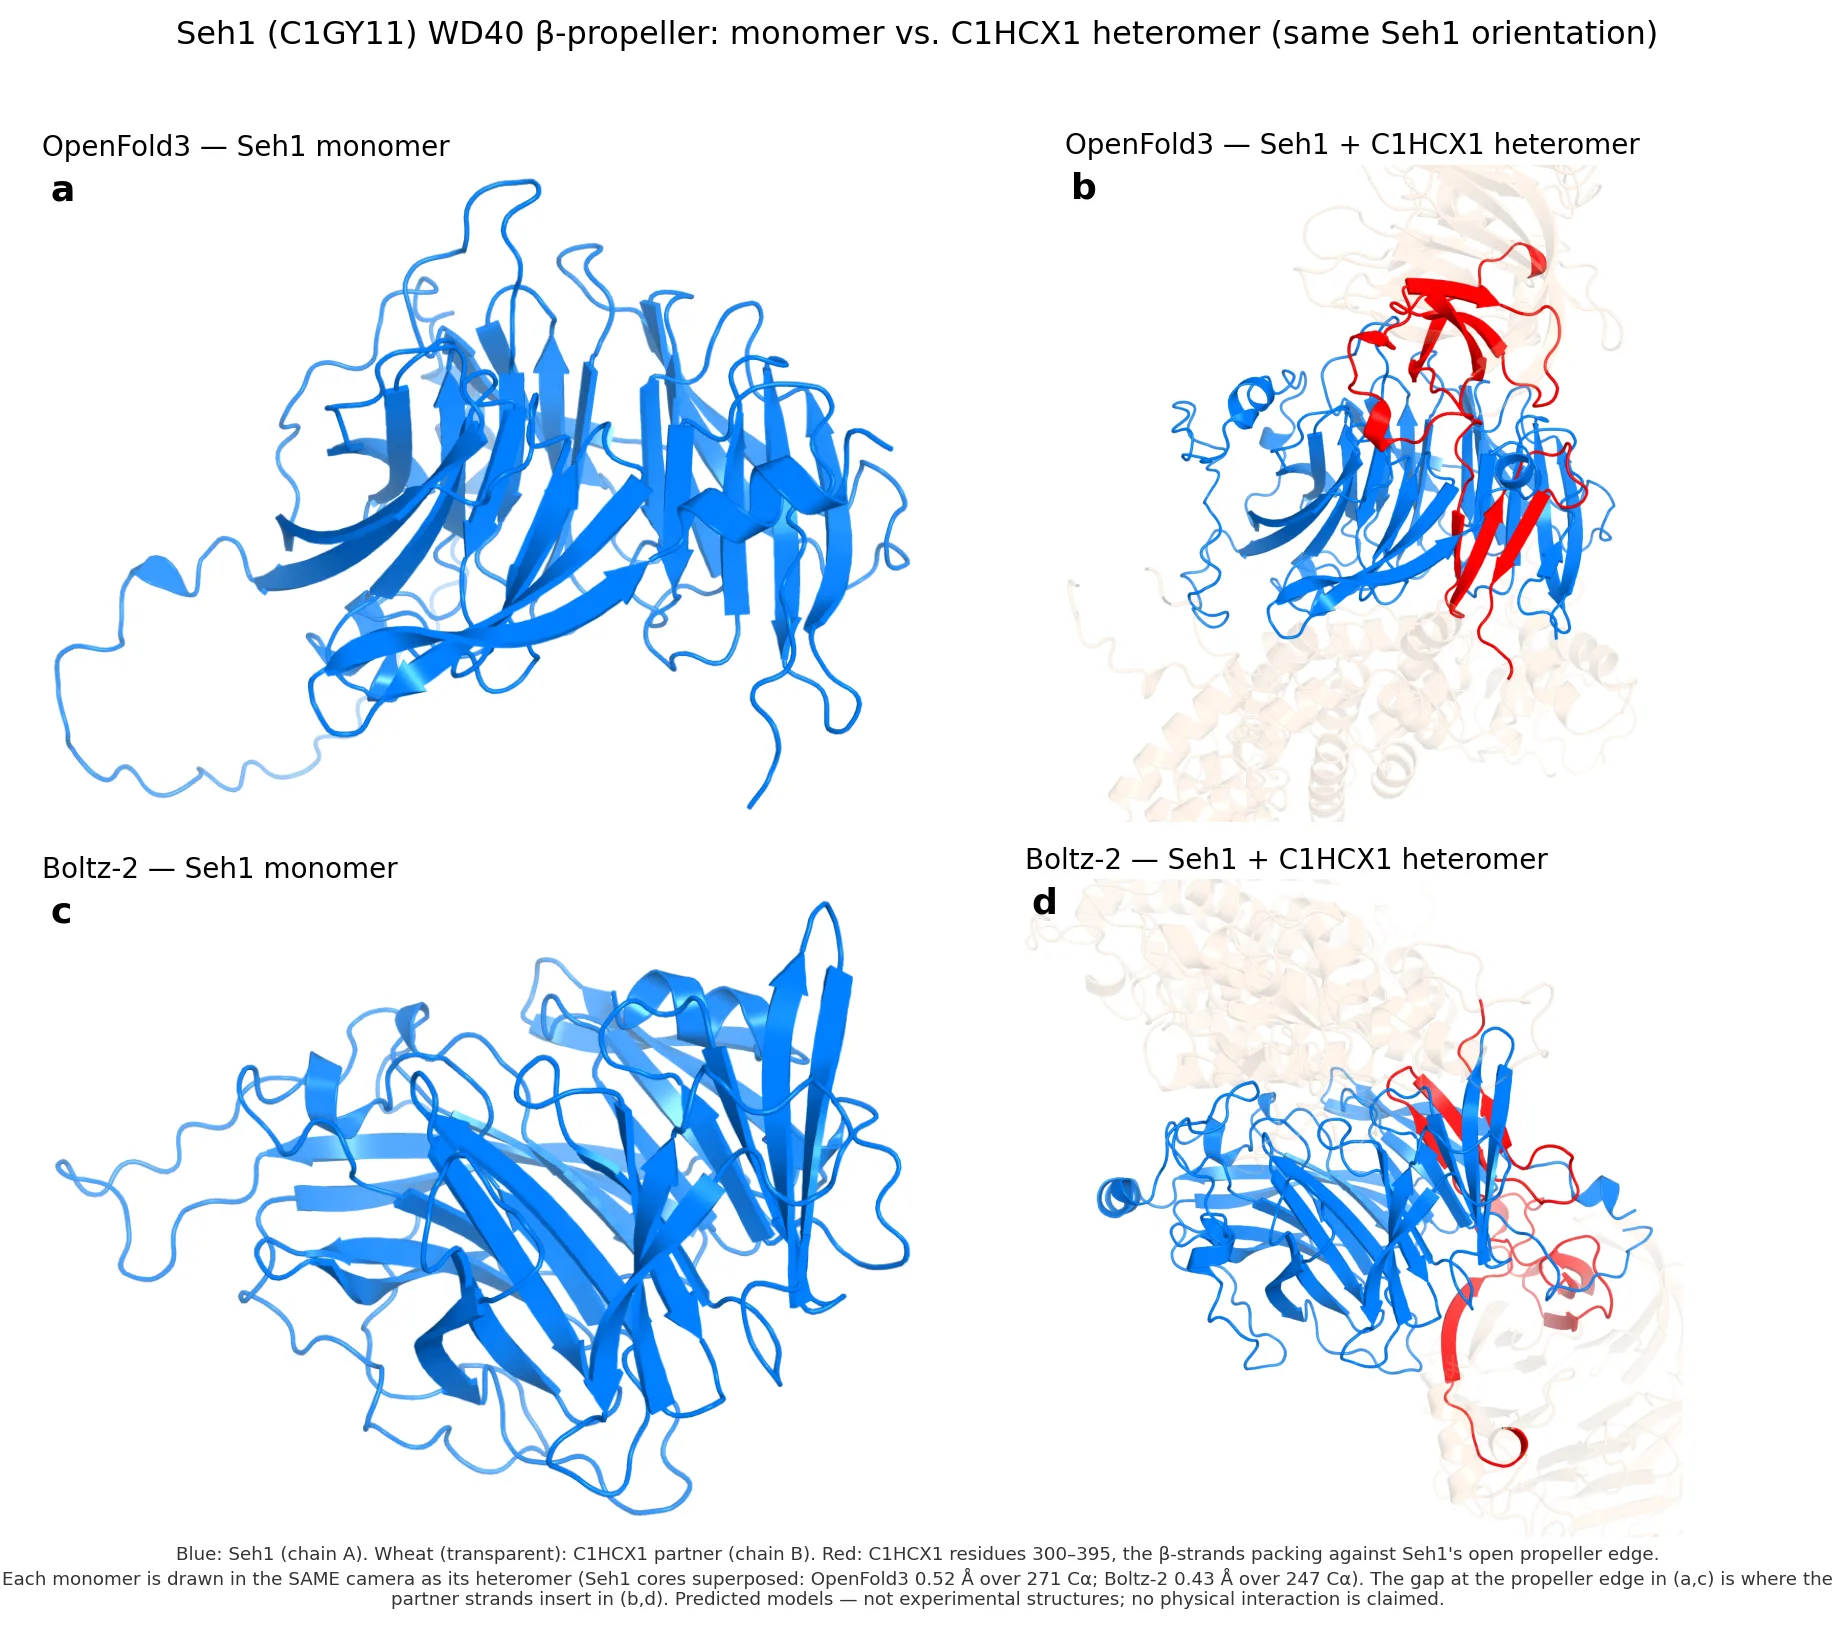
Důležité je, co text neprokazuje. Všechny výsledky jsou predikce a interakce C1GY11–C1HCX1 zatím nebyla experimentálně ověřena jako skutečná biologická vazba. Shoda dvou nezávislých modelů na stejné lokální geometrii je podle autorů přesvědčivá hypotéza, nikoli důkaz. Také čísla o zvýšené správnosti a efektivitě tokenů pocházejí z interních měření NVIDIA. Postup ukazuje, že agent zvládne celý řetězec kroků, o biologické pravdivosti ale nerozhodne.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Run NVIDIA BioNeMo NIM Microservices for Protein Structure Prediction in Claude Science | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.