
Když slovo agenta nestačí
Microsoftův nástroj ThinkingBox hodnotí agenty umělé inteligence podle záznamů, které po sobě zanechají v backendu, tedy v datech podnikového systému. Věty, kterými agent oznámí hotovou práci, jsou pro hodnocení druhořadé. Autoři navíc ke každému výsledku přidávají další otázku: zvládne to agent dvacetkrát za sebou? Důvod je praktický. Agent, který jednou uspěje, ještě není důvěryhodný zaměstnanec. Když systém mění záznamy v podnikových datech, nestačí vědět, že to umí v nejlepším případě. Důležité je, zda dokáže data správně upravit i při dalším pokusu a při tom následujícím. Právě tuhle slabinu chce benchmark odhalit. Podle autorů se ukazuje, že mezi jedním úspěchem a skutečnou spolehlivostí bývá velká propast. Následující části popisují, jak se měří, co čísla ukazují a kde jsou hranice jejich platnosti.
Hodnotí se výsledek, ne vyprávění
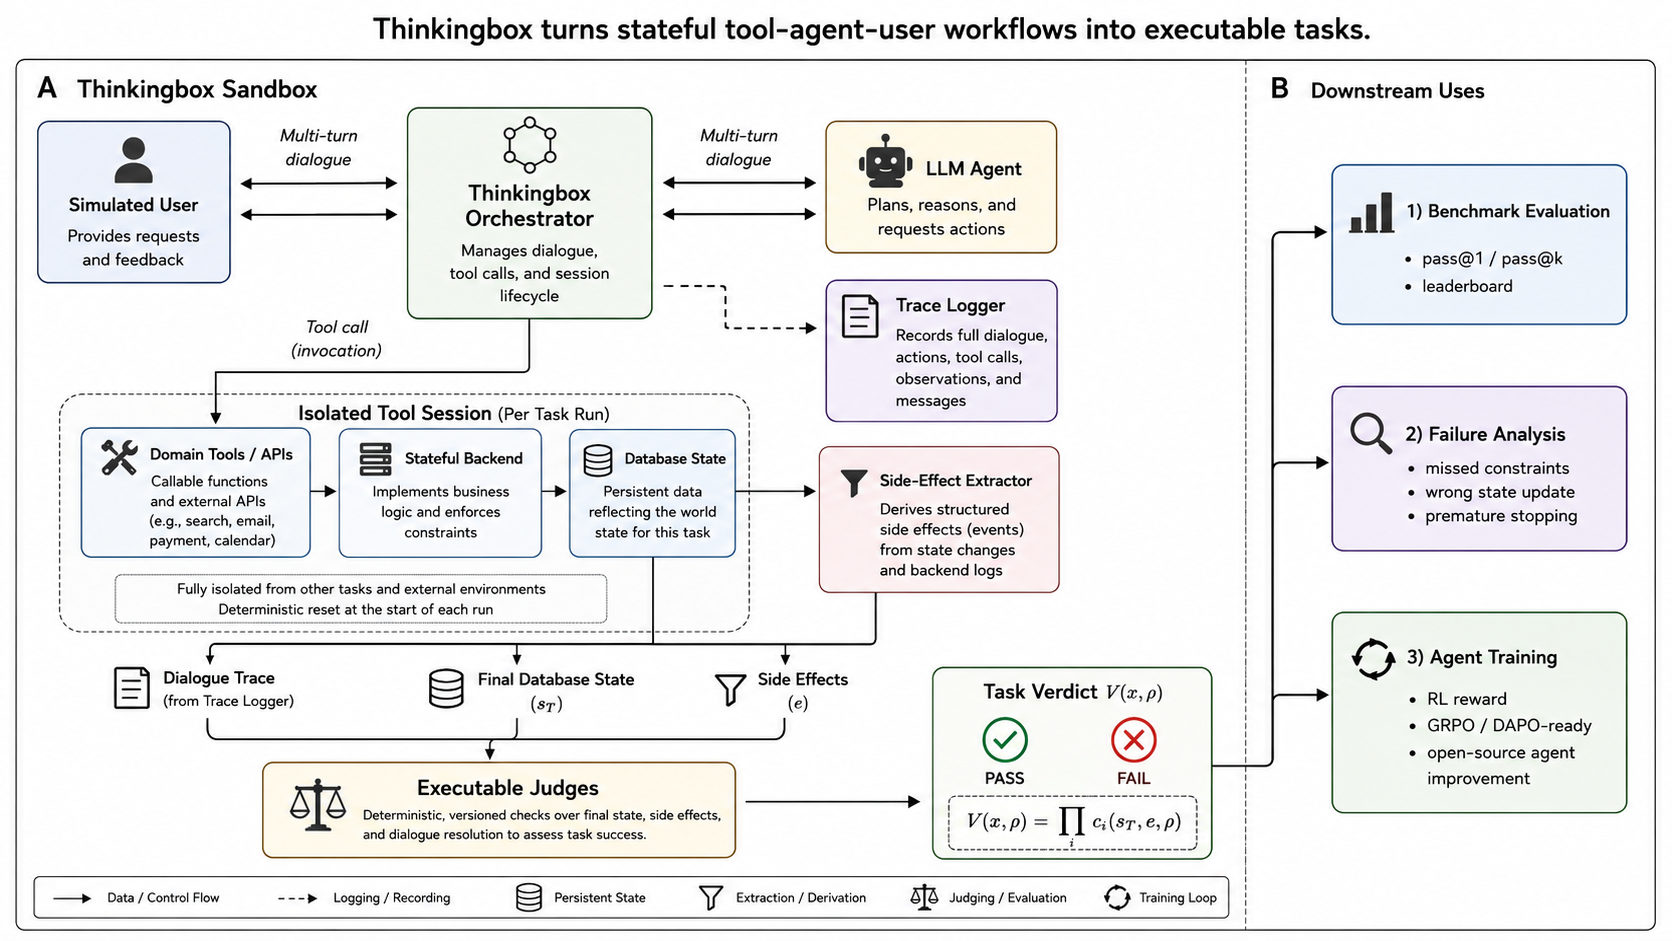
Většina testů agentů se dívá na to, co model napsal nebo jak vypadal jeho závěrečný report. ThinkingBox postupuje jinak. Po skončení pokusu se podle autorů zkoumá, co zůstalo v databázi, a výsledek se ověřuje exekuovatelnými kontrolami, tedy kontrolami, které se skutečně spustí nad výsledným stavem dat. Agent tak nemůže projít jen proto, že přesvědčivě popsal, co údajně udělal. Je to podobné, jako by účetní nehodnotil průvodní dopis k hotové zakázce, ale samotnou účetní knihu. Taková změna perspektivy má své důsledky. Plynulá a sebejistá odpověď, kterou jazykové modely běžně produkují, přestává být ukazatelem kvality. Rozhodující je, zda se v systému změnily správné řádky správným způsobem. Zdroj v dostupných pasážích nepopisuje podrobnosti jednotlivých kontrol, proto zůstává otevřené, jak přísné nebo úplné jsou u různých typů úloh. Princip hodnocení podle stavu systému je ale z textu zřejmý.
Čistý konec, špatný výsledek
Nejvýmluvnější je srovnání, které autoři provedli na společné sadě 121 680 platných pokusů u 12 velkých jazykových modelů. Exekuovatelnými kontrolami neprošlo 79 853 pokusů, tedy zhruba dvě třetiny z nich. U 67,24 % těchto selhání se přitom agent ukončil čistě, zavolal nástroj měnící stav a nenahlásil žádnou finální chybu nástroje. Jinými slovy: běh nespadl, agent skutečně sáhl do dat a nic v logu nenasvědčovalo problému. Zvenčí tedy vypadalo, že vše proběhlo hladce, a přesto výsledek v datech nesouhlasil s požadovaným stavem. Takové chyby ukazují, proč samotné sledování chybových hlášení nebo závěrečné odpovědi nestačí. Kdo by spoléhal jen na to, že se nenahlásila žádná chyba, přehlédl by velkou část skutečných selhání. Zdroj v dostupných pasážích nerozebírá, jaké konkrétní chyby se za těmito případy skrývají. Přesto je zřejmé, že nenápadná selhání tvoří podstatnou část všech neúspěchů.
Dvacet pokusů z čistého stolu
Spolehlivost se v ThinkingBoxu měří opakováním. Každá úloha běží 20krát nezávisle na ostatních a pokaždé startuje z identického čistého backendu. Každý pokus má navíc izolovanou relaci MCP s nově inicializovaným stavem. Dva pokusy téže úlohy tak nesdílejí řádek v databázi ani uložený stav nástrojů. Autoři zdůrazňují, že právě to dělá srovnání dvaceti pokusů smysluplným: žádný běh nepřebírá následky předchozího, takže se výsledky navzájem neovlivňují. Kdyby se zbytky starších pokusů hromadily v datech, nešlo by poznat, zda rozdíl vznikl náhodou v rozhodování agenta, nebo špinavým výchozím stavem. Při 507 úlohách to znamená přes deset tisíc běhů na jeden model. Autoři navíc uvádějí tři různá čísla, z nichž každé odpovídá na jinou otázku. V pasážích o výsledcích se opakuje jednopokusová úspěšnost pass@1, podíl úloh vyřešených alespoň jednou a podíl úloh, které uspějí ve všech dvaceti pokusech.
Kolik skóre přežije opakování
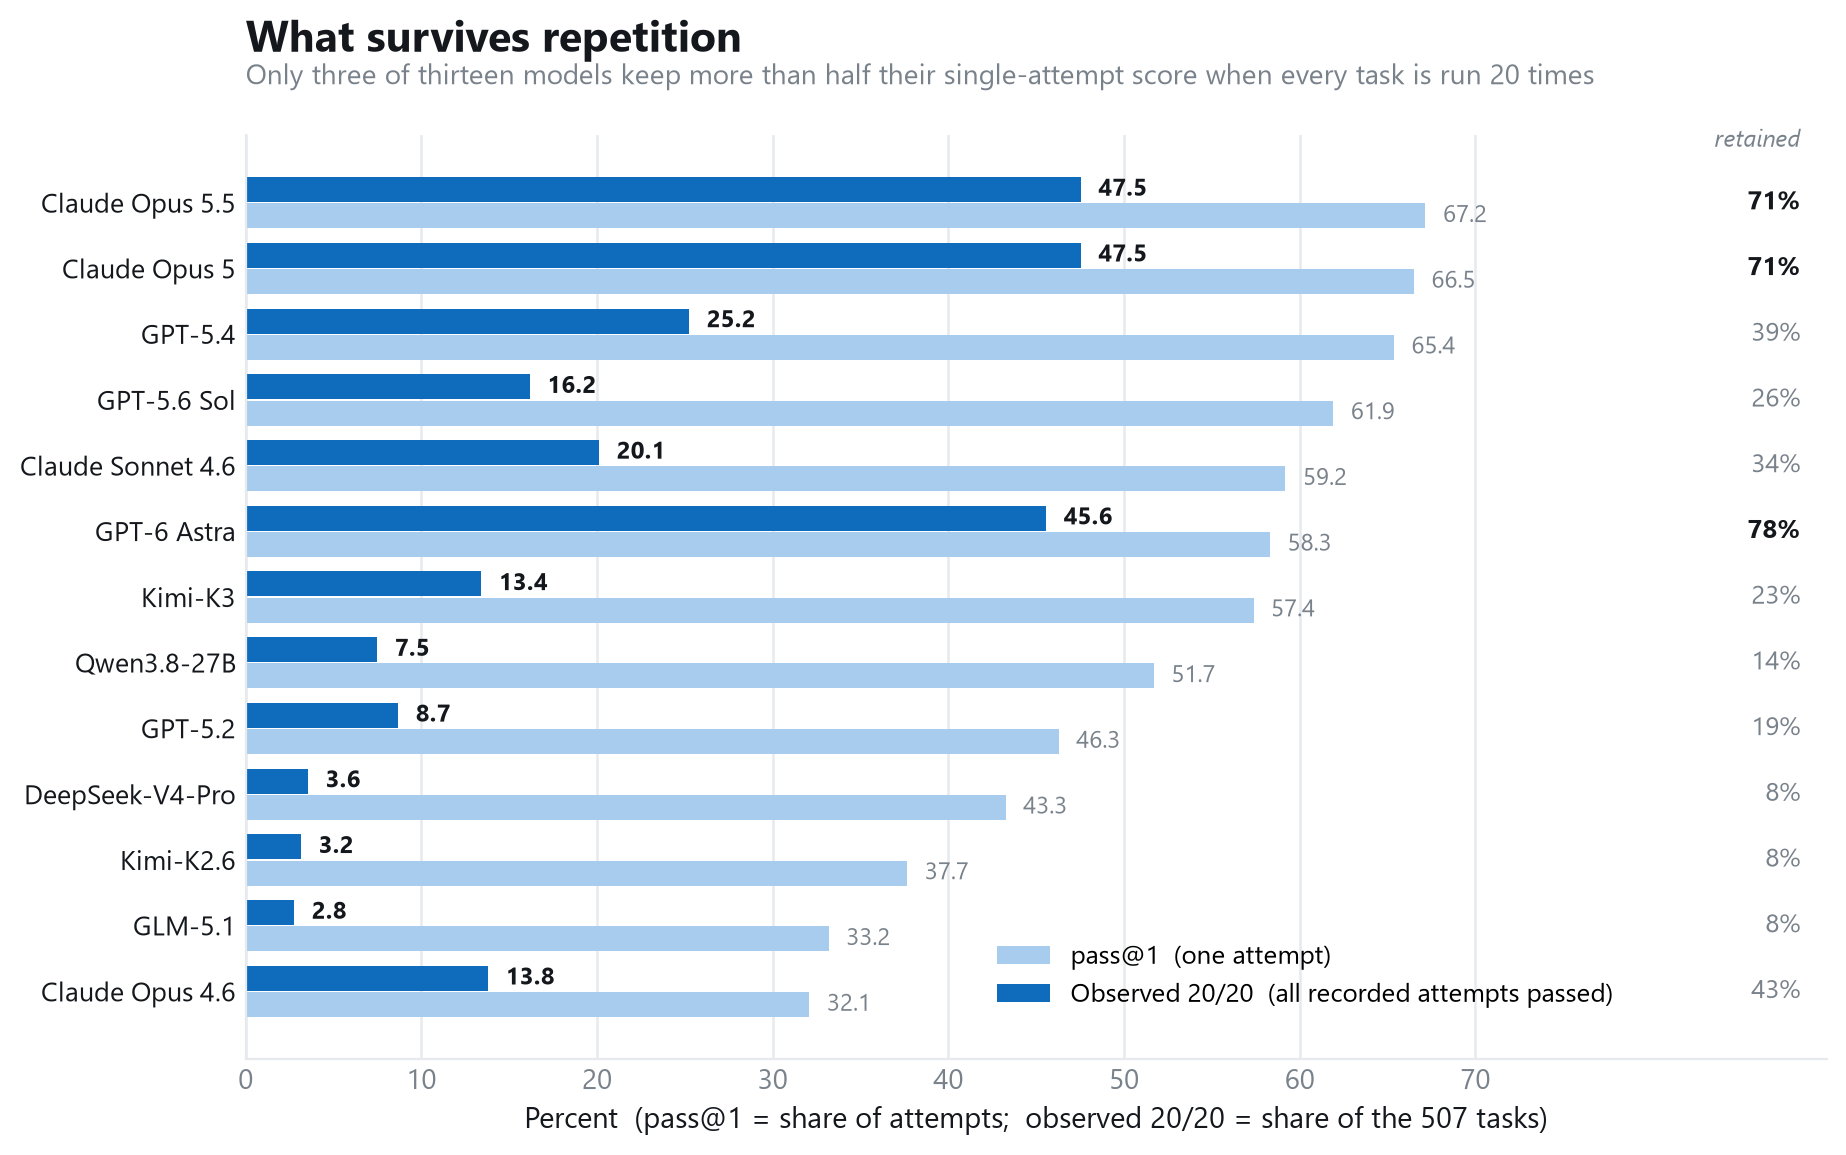
Rozdíl mezi jedním pokusem a dvaceti je podle autorů dramatický. Sledovanou veličinou je, jaká část skóre pass@1 zůstane zachována, když se úloha opakuje. Většinu svého jednopokusového skóre si po dvaceti opakováních udrží jen tři modely. GPT-6 Astra si ponechá 78 % jednopokusové úspěšnosti, Claude Opus 5.5 a Claude Opus 5 po 71 %. Na opačném konci stojí GLM-5.1, Kimi-K2.6 a DeepSeek-V4-Pro, kterým zůstává zhruba 8 %. U nich tedy z dobrého výsledku v jednom běhu zbývá po náročnější zkoušce jen zlomek. Model, který se v běžné tabulce jeví jako schopný, může být při požadavku na stálý výkon téměř nepoužitelný. Zdroj ale v použitých pasážích nevysvětluje, proč se modely tolik liší. Příčiny, například kolísání v rozhodování agenta, proto nelze z textu odvozovat. Zřejmé je jen to, že jednopokusová tabulka tyto rozdíly skrývá.
Dosáhnout a udržet
Dobře to ilustruje kontrast mezi Kimi-K3 a Claude Opus 5. Kimi-K3 vyřeší alespoň jednou 476 z 507 úloh, tedy 93,89 %. Ve všech dvaceti pokusech ale uspěje jen u 68 úloh, což je 13,41 %. Znamená to, že většina úloh, které někdy zvládl, mu vyjde jen občas. Claude Opus 5 řeší alespoň jednou méně úloh (79,09 %), 106 úloh mu v žádném pokusu nejde. Zato 47,53 % benchmarku zvládne při každém pokusu. Pro podnik, který potřebuje předvídatelný provoz, je právě druhý údaj užitečnější než první. Ukazuje, že potenciál modelu a jeho stálost jsou dvě různé vlastnosti. Pořadí podle toho, co model umí aspoň někdy, se proto může výrazně lišit od pořadí podle spolehlivosti. Kdo vybírá agenta jen podle nejlepšího případu, riskuje, že zvolí model, na který se nedá spolehnout.
Kolik stojí spolehlivá úloha
Autoři přepočítávají i náklady, a to na úlohu zvládnutou ve všech dvaceti pokusech. Podle jejich odhadu stojí GPT-6 Astra 7,45 USD na spolehlivě vyřešenou úlohu, Claude Opus 5.5 7,80 USD a Claude Opus 5 13,30 USD. Tento údaj vzniká tak, že se odhadované náklady na dvacet běhů vydělí počtem úloh, které prošly 20 z 20 pokusů. Opus 5.5 a Opus 5 přitom zvládají stejný počet takových úloh, 241. Odhadované náklady na dvacet běhů ale činí 1 880,77 USD u Opusu 5.5 a 3 206,00 USD u Opusu 5. Za stejný výsledek tedy stojí druhý z nich o více než 1 300 USD víc. GPT-6 Astra dosahuje 231 úloh za 1 720,60 USD. V tabulce autorů je ještě levnější GPT-5.4, který vychází na 6,80 USD, ale spolehlivě zvládá jen 128 úloh. Jde o odhad autorů, ne o ceník dodavatelů, takže skutečná cena v konkrétním nasazení se může lišit.
Nejlevnější úspěch není nejlevnější spolehlivost
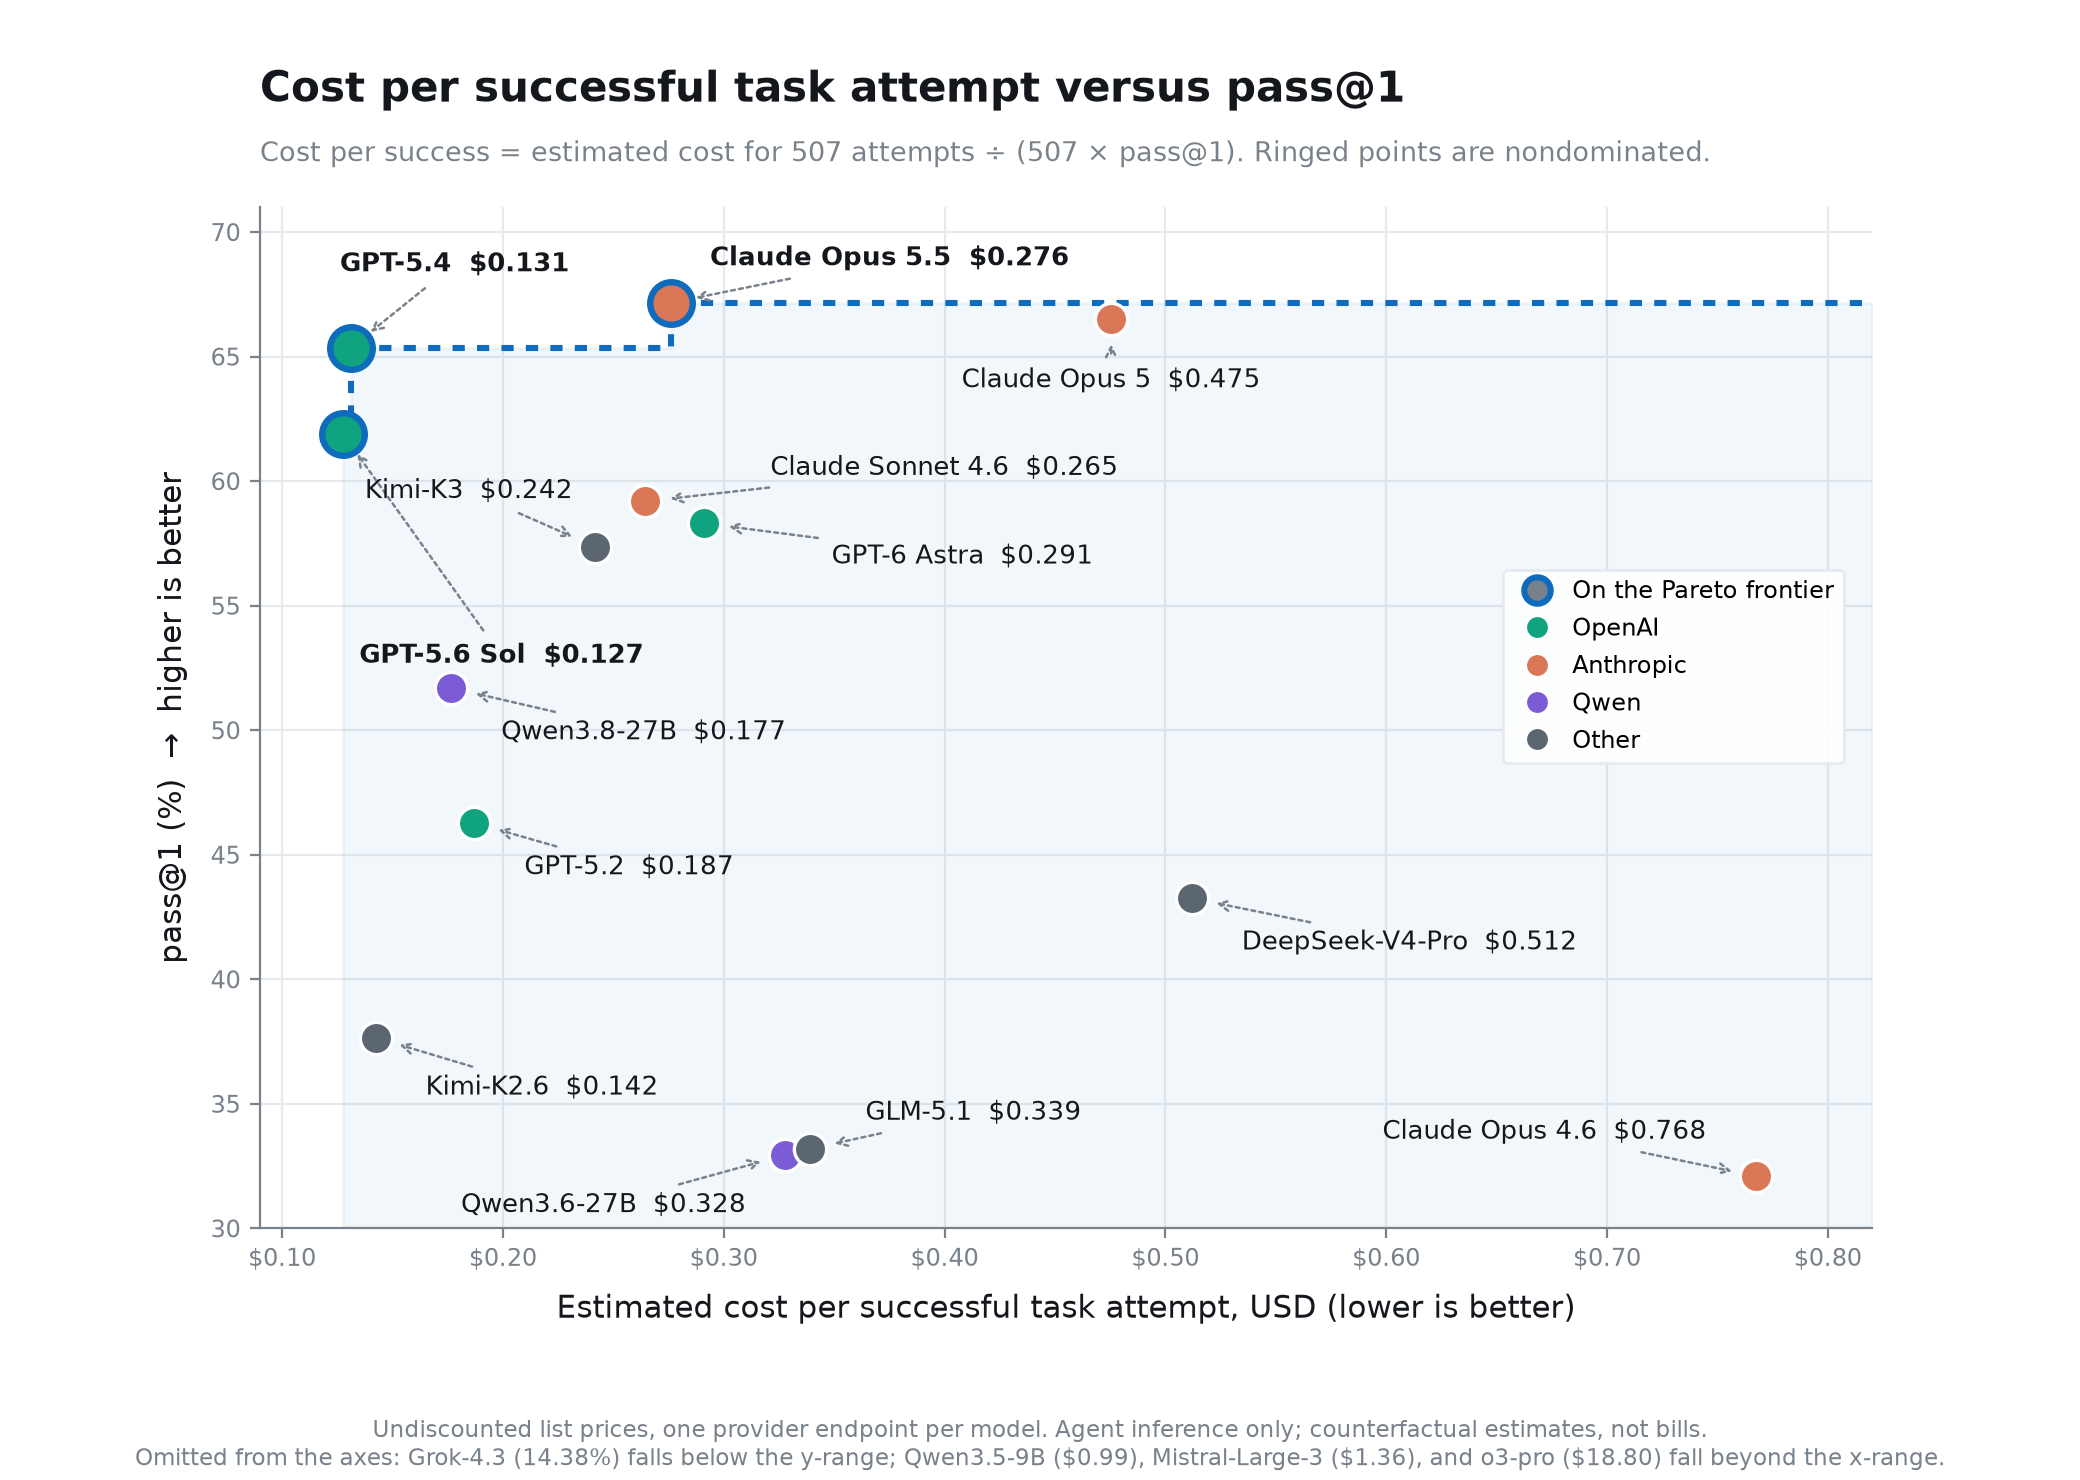
Zajímavý je případ GPT-5.6 Sol. Na jeden úspěšný pokus je nejlevnější, stojí 0,127 USD. Když ale autoři počítají cenu za úlohu, kterou model zvládá spolehlivě, vychází 9,76 USD. Spolehlivě přitom projde jen 82 úloh, tedy 16,17 % benchmarku, při odhadovaných nákladech 800 USD na dvacet běhů. Levný pokus se tak neukáže jako levné řešení, pokud model často selže a výsledek je nutné opakovat nebo kontrolovat. Podobně je to u Kimi-K3, který podle tabulky zvládá 68 úloh a vychází na 20,68 USD za spolehlivou úlohu. Autoři proto vedle jednoduché ceny sledují i takzvanou Paretovu hranici. Model na ní leží, pokud neexistuje jiný, který by byl současně nejvýše stejně drahý a aspoň stejně přesný. Obrázek ukazuje, že hranici tvoří jen tři modely a ostatní jsou v jedné z os překonané. Které tři to jsou, dostupné pasáže neuvádějí.
Co benchmark nedokazuje
Při čtení výsledků je potřeba mít na paměti několik omezení. Všechny úlohy ve veřejném benchmarku jsou syntetické rekonstrukce. Workflow a pravidla vycházejí podle autorů ze skutečných vzorů firemních agentů, ale zákazníci jsou fiktivní. Výsledky tedy nemusí platit pro konkrétní podnikový systém s vlastními daty, výjimkami a zvyklostmi. Text pochází od zaměstnance Microsoftu, tedy od strany, která nástroj představuje, a jde o její vlastní hodnocení. Nezávislé ověření v použitém zdroji chybí. Otevřené zůstává také to, zda počet dvaceti opakování odpovídá požadavkům konkrétních aplikací. Některé provozy by snesly méně pokusů, jiné by chtěly víc, ale zdroj to nerozebírá. Hlavní poselství je přesto jasné: u agentů, kteří mění data, je třeba ověřovat stav systému po skončení práce a měření opakovat. Teprve takové číslo říká, zda lze agentovi práci opravdu svěřit.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- The Agent Said It Was Done. The Database Disagreed. — Hugging Face Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.