
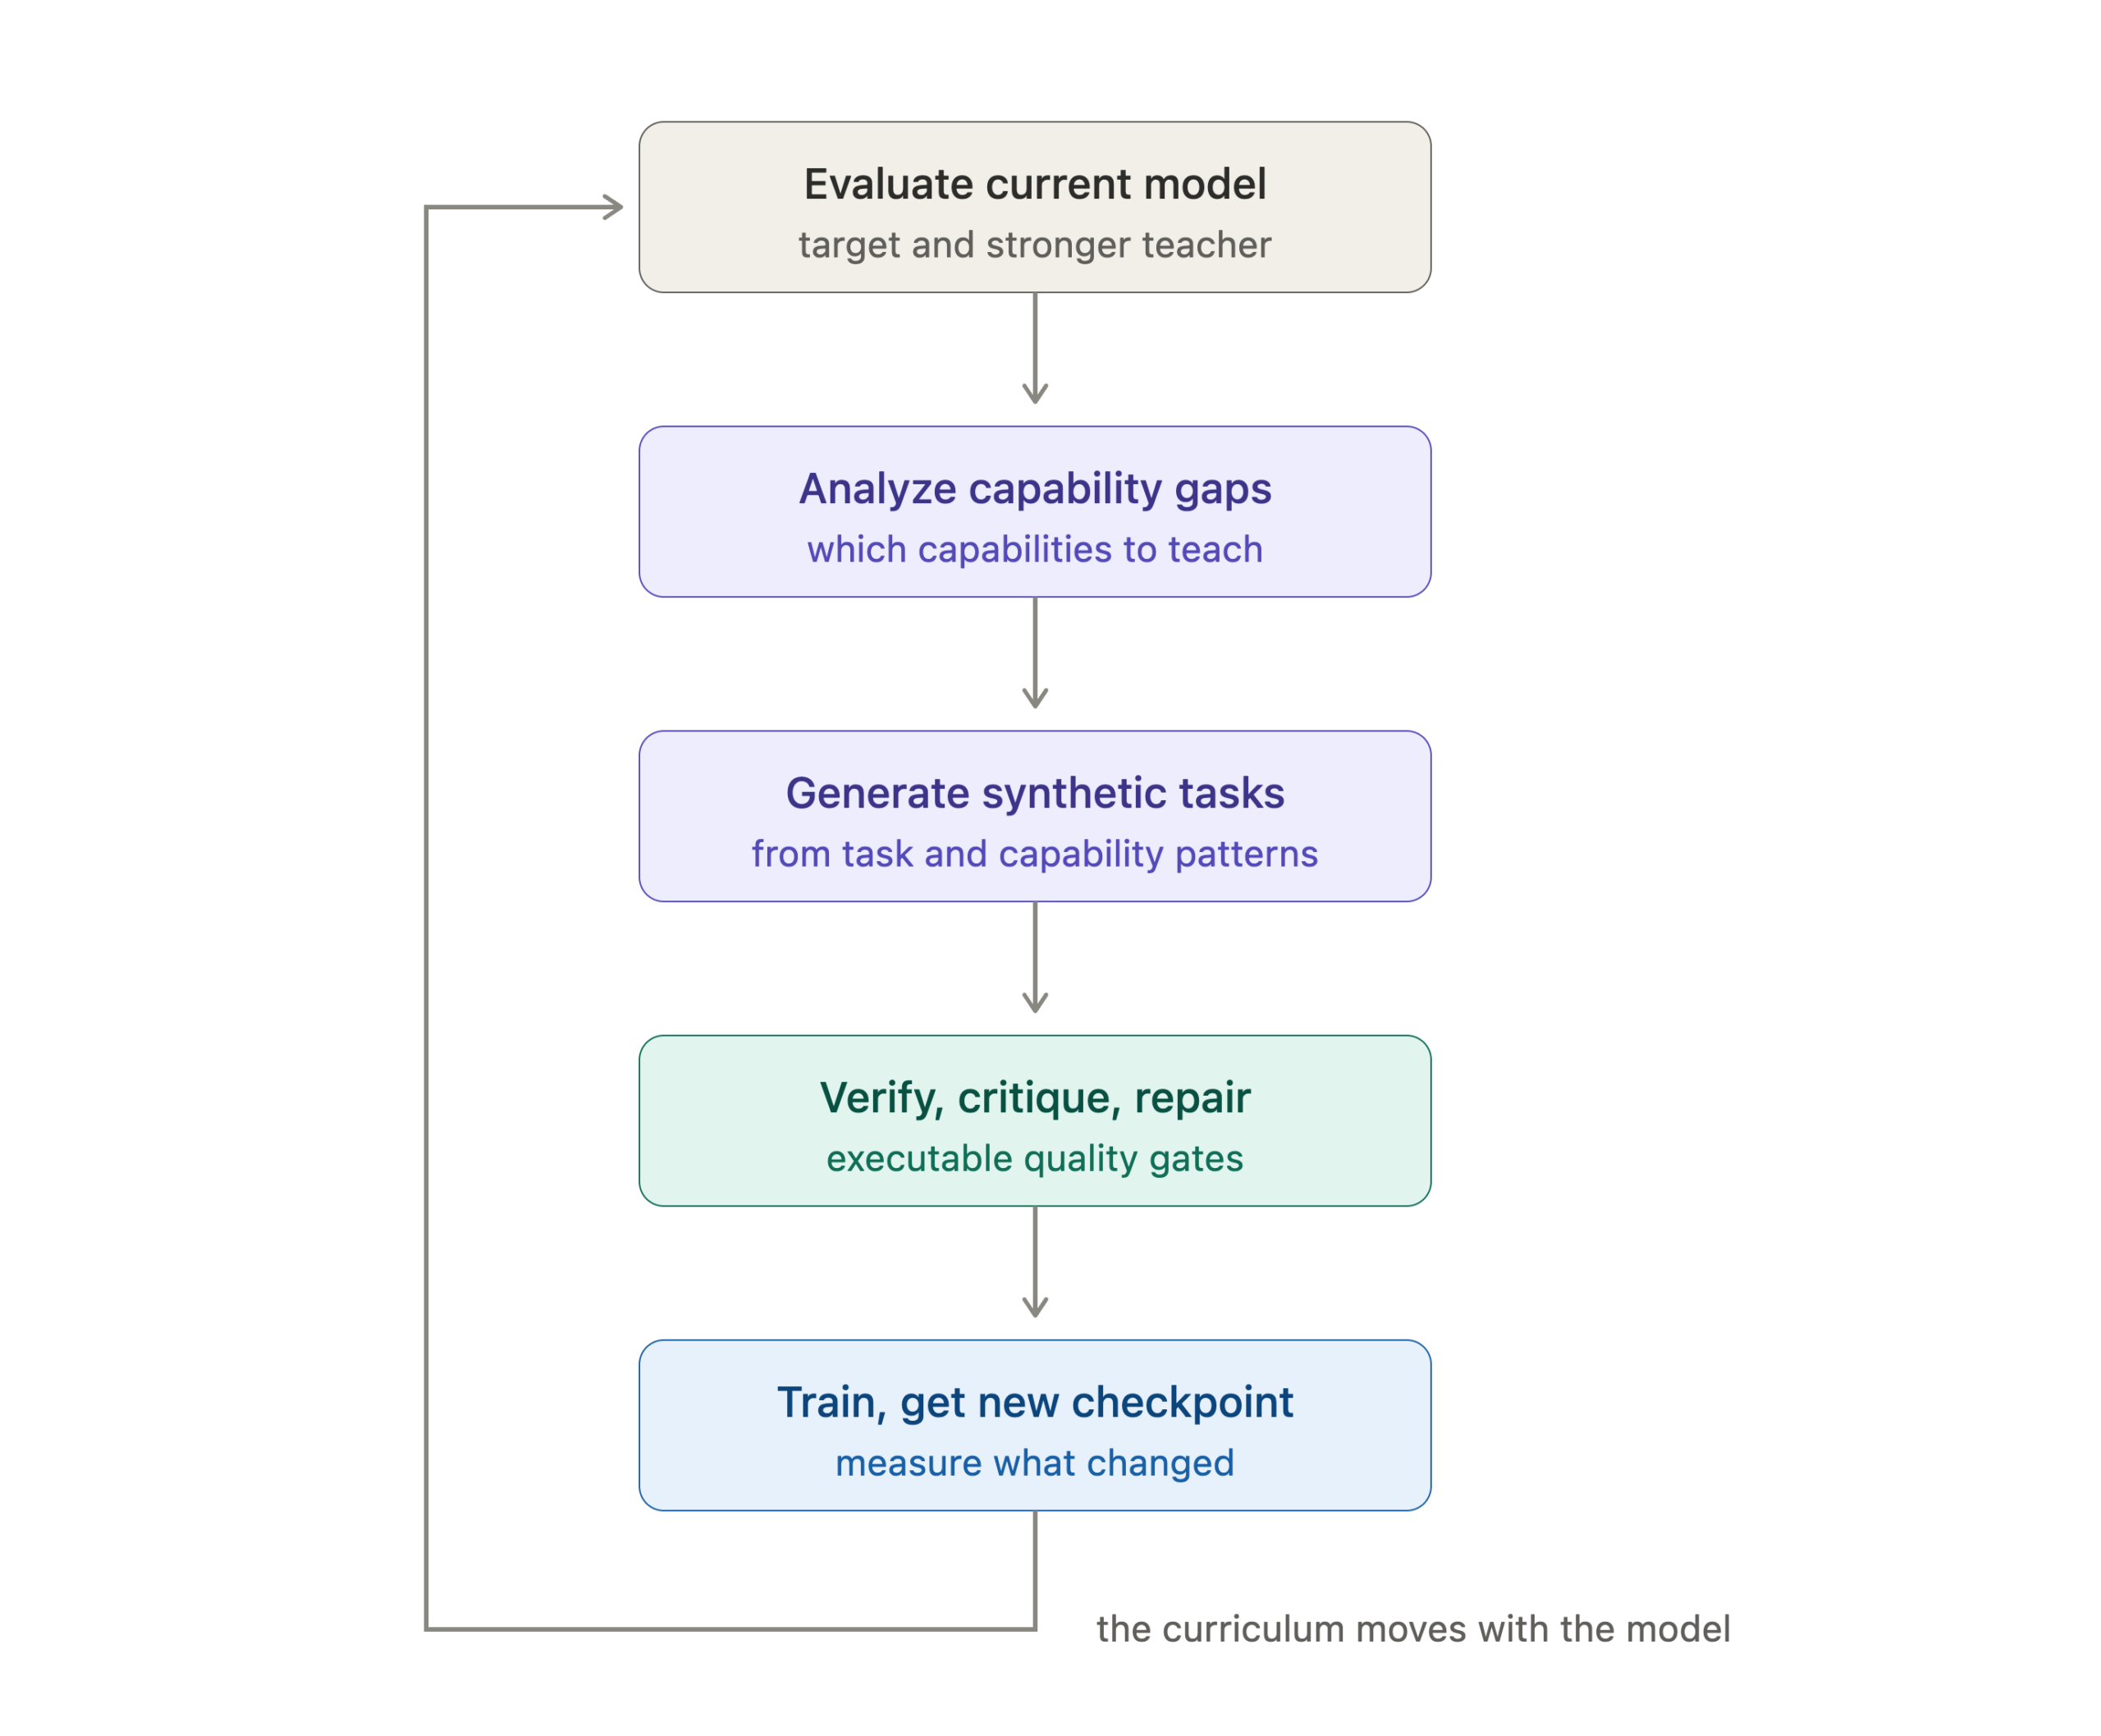
Tým ServiceNow CoreAI vyvinul nástroj AutoSynthData, který mění mezery ve schopnostech agenta v konkrétním podnikovém prostředí na trénovací data. K tomu využívá selhání cílového modelu a zároveň úspěchy silnějšího učitelského modelu. Na jejich základě nástroj určuje, co se má model učit dál, a poté generuje a ověřuje nové úkoly, které tyto schopnosti procvičují.
Celý postup začíná diagnostikou cílového modelu v daném prostředí, kde AutoSynthData hledá vzorce v úkolech, s nimiž model neuspěl. Silnější učitelský model následně pomáhá určit, které z těchto úkolů jsou vůbec řešitelné a jak vypadá správné chování. Výsledné nedostatky jsou převedeny na nové spustitelné úkoly, které jsou v prostředí kontrolovány a následně využity pro dotrénování modelu. Opakované vyhodnocení aktualizovaného modelu pak odhaluje zbývající mezery, což slouží jako vodítko pro další kolo generování dat. Tento iterativní proces vytváří uzavřenou smyčku zpětné vazby, kde každé nové kolo dotrénování modelu posouvá jeho schopnosti dál a zároveň zpřesňuje diagnostiku zbývajících nedostatků. Díky tomu je generování dat dynamické a přizpůsobuje se aktuální úrovni znalostí modelu, což maximalizuje efektivitu každého trénovacího kroku.
Generování dat bez kopírování
Generování dat bez kopírování probíhá tak, že evaluační úlohy nejsou předávány generátoru v jejich původní podobě. Místo toho dochází k analýze těchto úloh, ze které vznikají očištěné karty specifikace schopností. Tyto karty slouží jako základní vodítko pro generátor, který na jejich základě vytváří zcela nové úlohy. Tento proces zajišťuje, že výsledné trénovací sady obsahují jiná zadání, odlišné stavy i nové cesty k nalezení řešení, což zabraňuje prostému reprodukování existujících dat. Karty specifikace schopností fungují jako abstraktní definice toho, co by měl model ovládat, aniž by obsahovaly konkrétní data z testovacích sad. Tato metoda destilace informací zajišťuje, že generátor vytváří úlohy, které testují stejnou kognitivní schopnost nebo technický postup, ale v úplně jiném kontextu. Praktickým přínosem je eliminace rizika, že by se model naučil pouze konkrétní odpovědi na konkrétní otázky, místo aby pochopil obecný princip řešení daného typu problému.
Klíčovým prvkem tohoto přístupu je striktní oddělení vstupních dat od procesu tvorby. Generátor totiž nedostává původní prompty, konkrétní entity ani trajektorie z původních úloh. Stejně tak mu nejsou poskytovány detaily z verifikátoru, což znemožňuje přímé kopírování obsahu. Díky využití zmíněných specifikačních karet může systém efektivně vytvářet nové scénáře, které procvičují požadované schopnosti, aniž by model pouze memoroval konkrétní příklady z evaluačních sad. Tento přísný režim zajišťuje, že generátor pracuje pouze s abstraktními požadavky na schopnosti, nikoliv s konkrétními datovými záznamy. Tím je zcela eliminována možnost, že by do trénovací sady unikly prvky z evaluačních testů, což by mohlo vést k falešnému pocitu zlepšení výkonu v důsledku mírného přeb लर्निंगu (overfittingu).
Přísná kontrola kvality dat
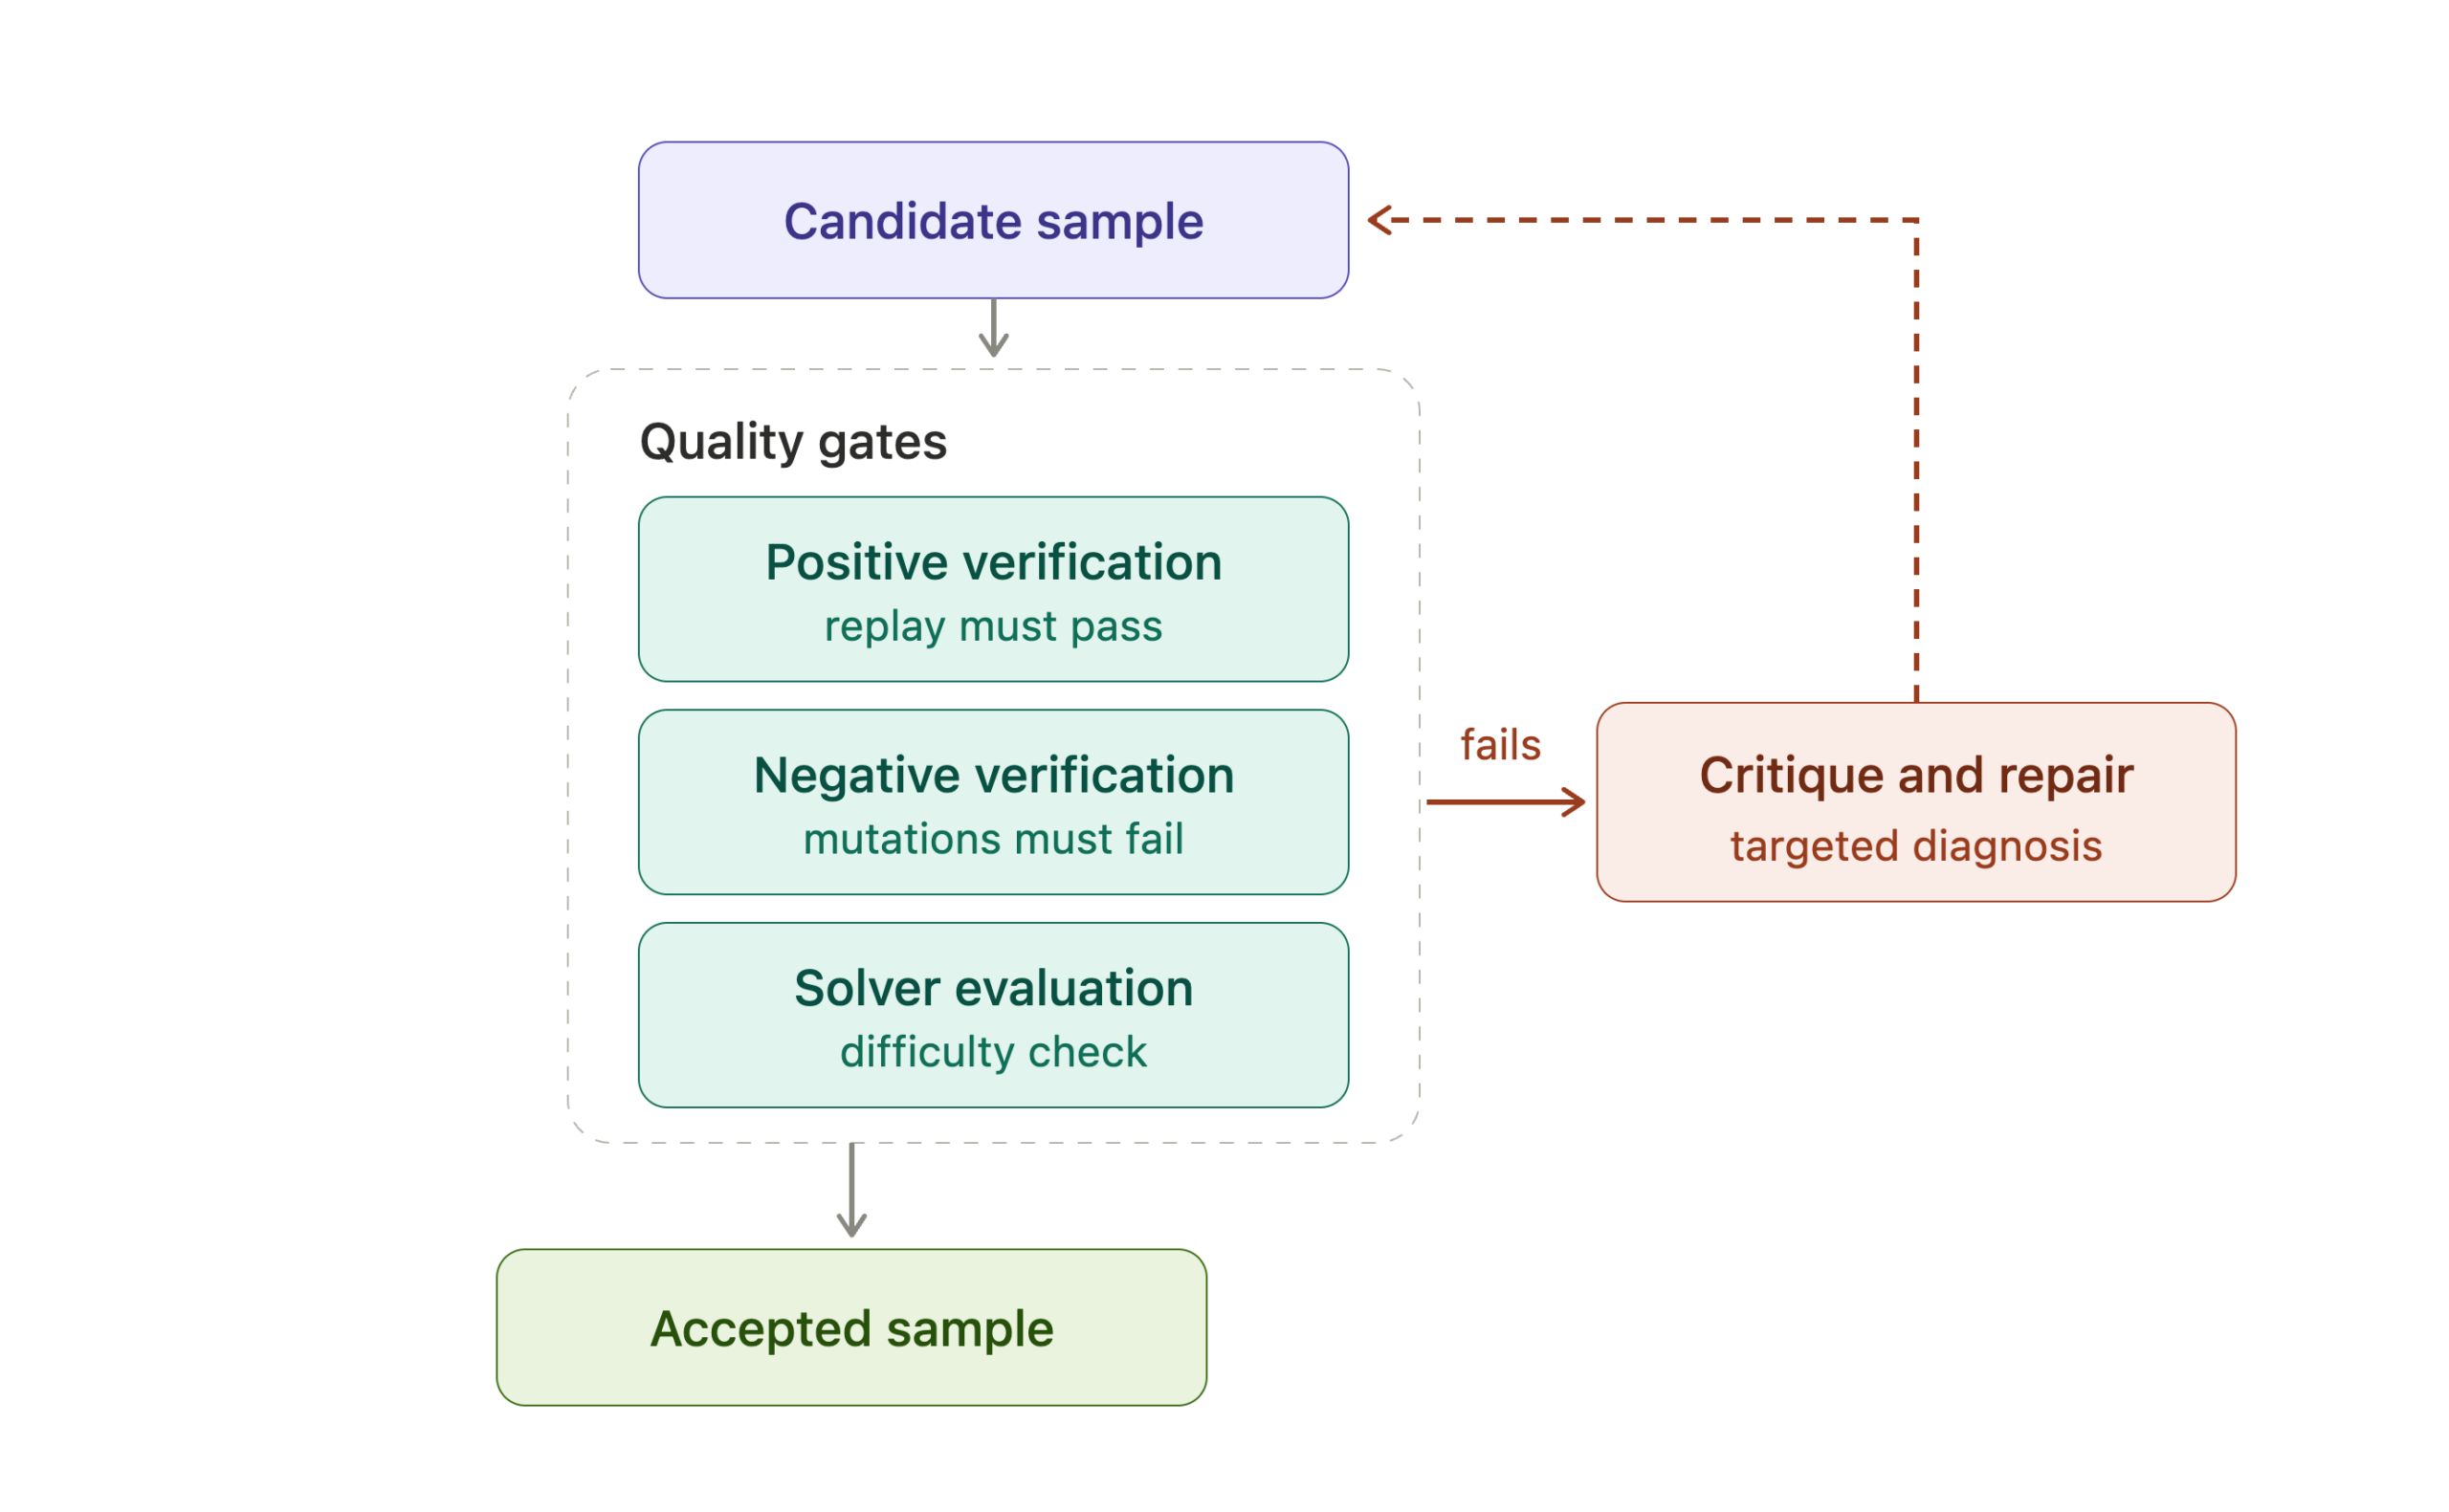
Kontrola kvality dat začíná u každého kandidáta vyhodnocením řešitelem, které slouží k měření náročnosti úloh. V použité konfiguraci systém upřednostňuje úkoly, které cílový model vyřeší nejvýše v jednom ze tří pokusů, zatímco silnější řešitel musí uspět alespoň ve dvou ze tří pokusů. Prahem je tedy maximálně 1/3 úspěšnosti u cílového modelu a minimálně 2/3 u silnějšího řešitele. Kandidáti dále procházejí pozitivním a negativním ověřením a omezenou opravou.
Kromě měření obtížnosti musí kandidáti projít procesem pozitivního a negativního ověření, které je doplněno o omezený proces opravy. Celý tento cyklus kontroly kvality na úrovni jednotlivých vzorků je znázorněn v procesu verifikace a opravy, který musí každý kandidát úspěšně absolvovat před samotným vstupem do trénovacího datasetu. Tímto postupem AutoSynthData filtruje nekvalitní data a udržuje vysoký standard generovaných podkladů pro následné učení modelů. Tento víceúrovňový filtr zajišťuje, že do finálního datasetu proniknou pouze ty úlohy, které jsou pro cílový model skutečně přínosné – tedy takové, které jsou dostatečně těžké na to, aby ho rozvíjely, ale zároveň objektivně řešitelné, což potvrzuje úspěšnost silnějšího modelu.
Kvantifikovatelné zlepšení výkonu
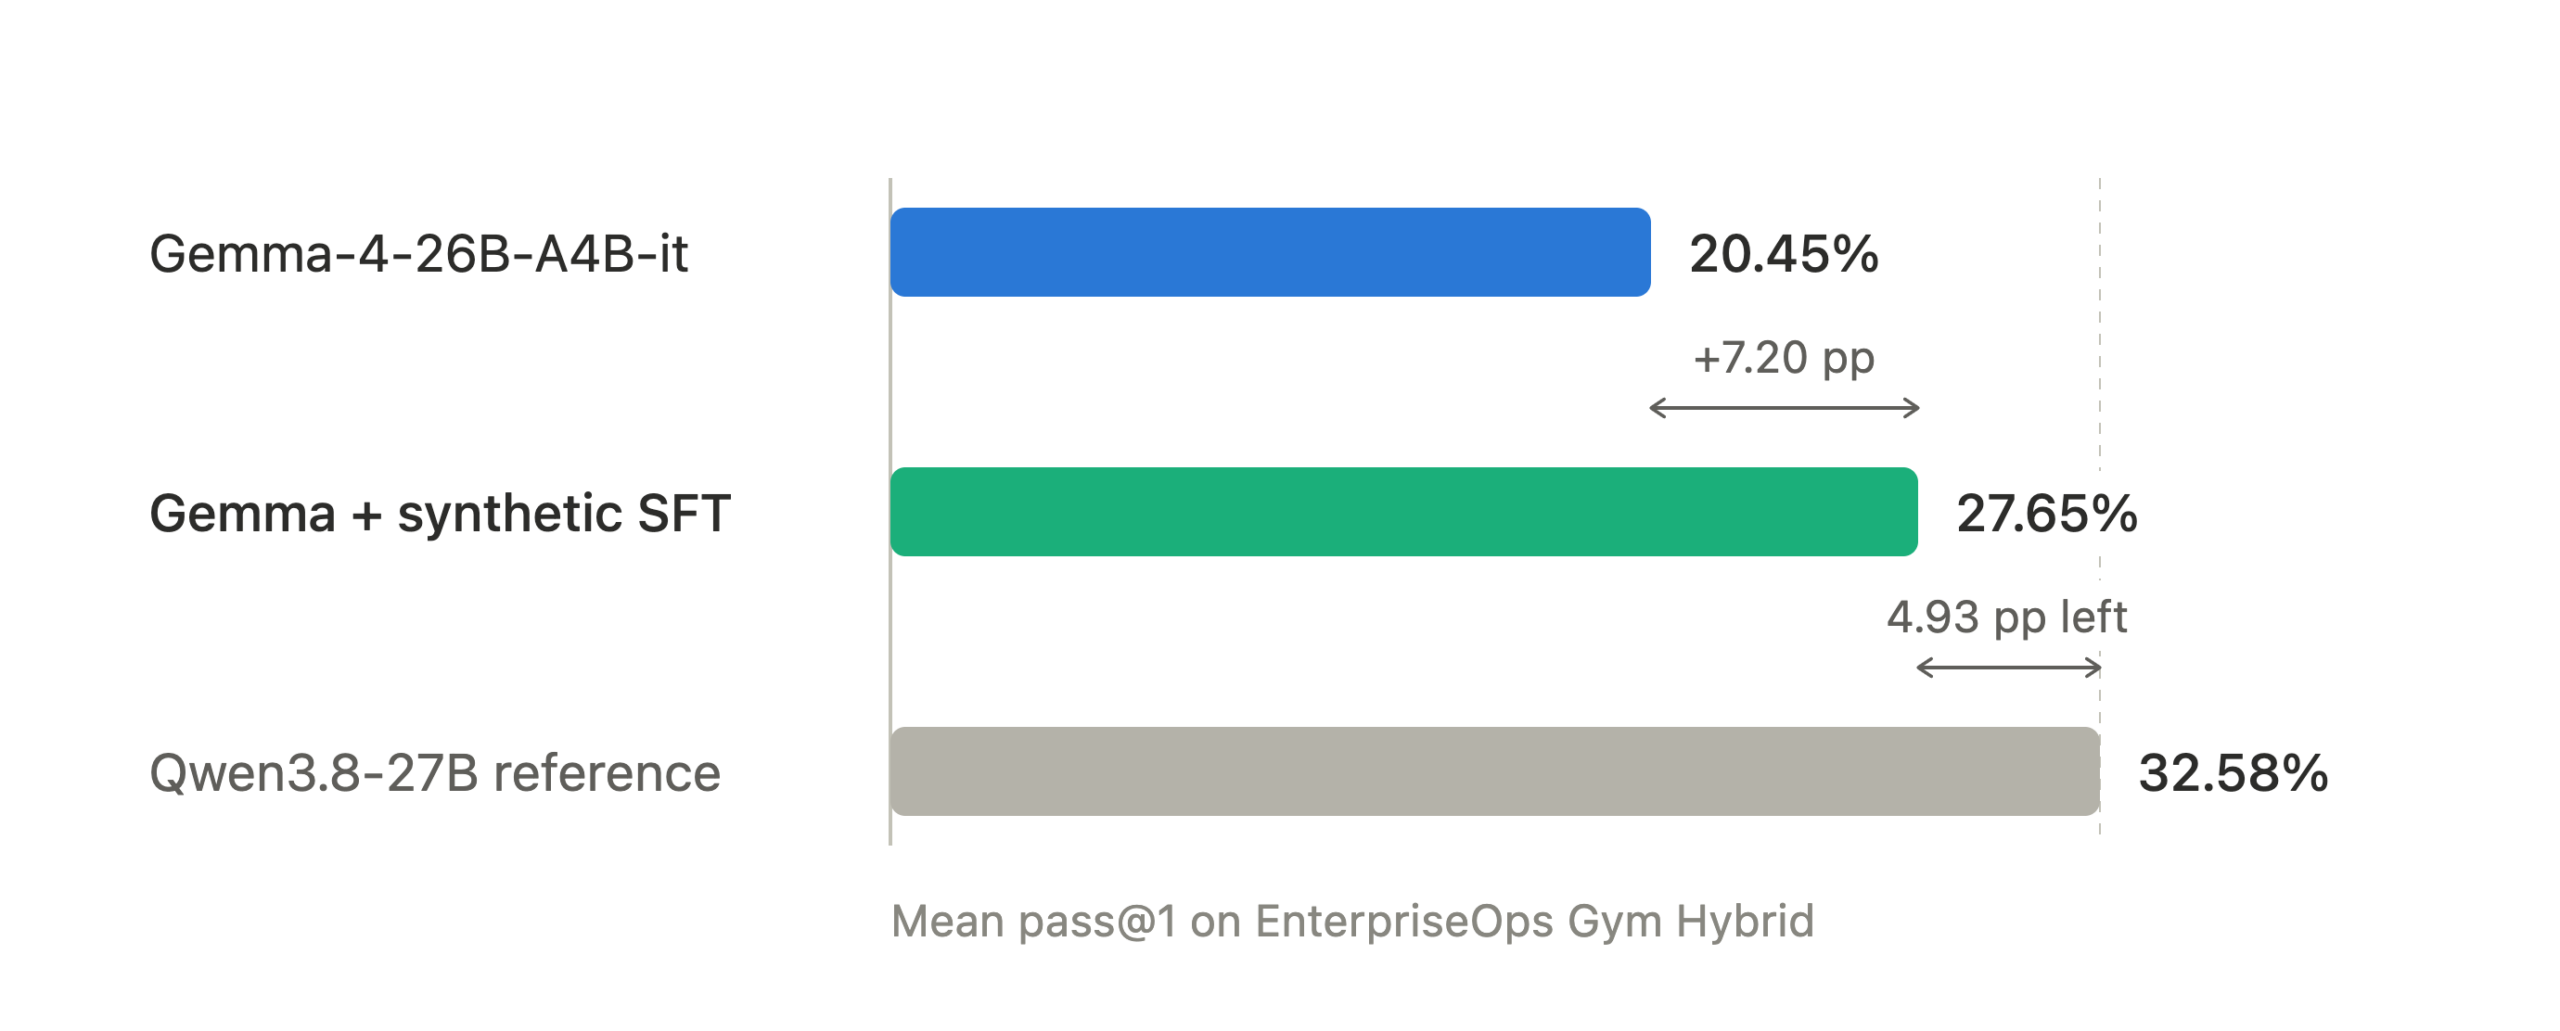
Zlepšení výkonu autoři ověřili v doméně Hybrid v prostředí EnterpriseOps Gym. Jako cílový model použili Gemma-4-26B-A4B-it a jako učitele Qwen3.8-27B. Model natrénovaný na syntetických datech zlepšil průměrné Pass@1, tedy úspěšnost při prvním pokusu, o 7,2 procentního bodu, což představuje relativní nárůst o 35 %. Úspěšnost podle verifikátoru přitom vzrostla z 63,01 % na 68,55 %.
K potvrdení univerzálnosti tohoto přístupu autoři aplikovali metodu AutoSynthData i v doméně ITSM. V tomto scénáři opět sloužil model Gemma jako cílový model, avšak v roli učitele byl nasazen DeepSeek-V4.1-Flash. Výsledky ukázaly, že průměrné Pass@1, tedy úspěšnost při prvním spuštění, vzrostlo z 18,77 % na 27,18 %. Autoři tyto výsledky uvádějí jako důkaz toho, že navržený postup funguje i v druhé odlišné doméně a pomáhá zvyšovat výkonnost modelů i v jiných kontextech než v doméně Hybrid. Tento nárůst úspěšnosti v doméně ITSM potvrzuje, že metodika není vázána na specifika jedné oblasti, ale lze ji aplikovat na různé typy podnikových úloh. Schopnost systému adaptovat se na odlišné domény s využitím různých učitelských modelů podtrhuje robustnost celého navrženého procesu generování syntetických dat.
Kontext a omezení experimentů
Autoři výsledek z Hybridu výslovně vztahují jen k prostředí EnterpriseOps Gym Hybrid, které bylo v experimentu použito. Zlepšení v něm podle nich ukazuje hodnotu přístupu v kontrolovaném prostředí. Výsledky tak představují ukázku fungování metody za podmínek tohoto experimentu.
Důležitým aspektem metodiky bylo oddělení tréninkových a evaluačních úloh. Úlohy určené pro trénink vznikly nově na základě specifikací schopností a generátor původní evaluační úlohy v průběhu procesu neobdržel.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- AutoSynthData: Generating Training Data for Enterprise Agents — Hugging Face Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.