
Výzkumníci z Microsoft Research představili nový framework Agent Lightning, který řeší zásadní nedostatek v učení agentů pomocí posilovaného učení (RL). Většina dosavadních systémů pro agentní RL totiž vyžaduje, aby vývojáři znovu implementovali agenta uvnitř trénovacího frameworku. Taková přeimplementace je nákladná a trénovaný agent pak není zcela stejný jako ten, který se nasazuje do provozu.
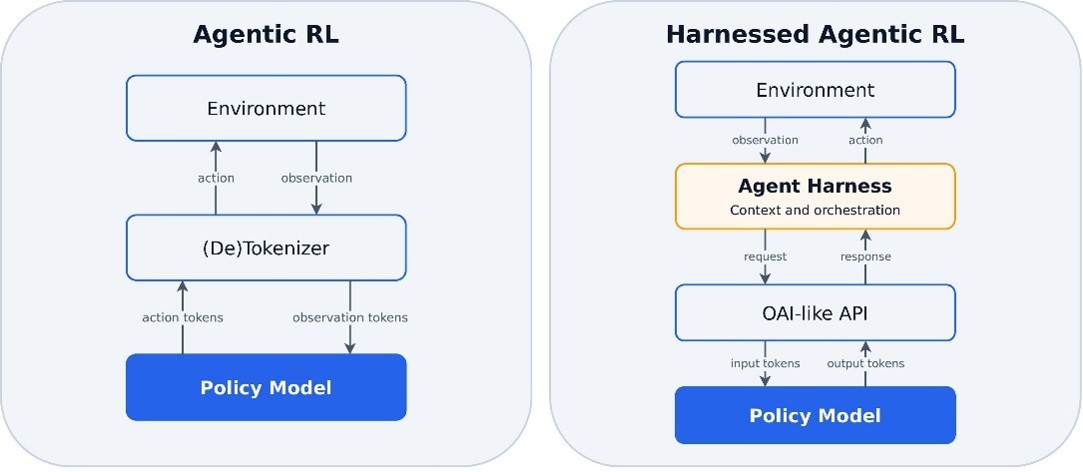
Důsledkem tohoto přístupu je, že agent, který prochází trénováním, není zcela totožný s verzí, která je následně nasazena do provozu. Srovnání tradičního agentního RL s novým přístupem Harnessed Agentic RL ukazuje, že nový model umožňuje, aby se agent s rámcem (harness) použitým v nasazení přímo účastnil posilovaného učení. Agenta tak není nutné znovu implementovat uvnitř trénovacího frameworku.
Nový přístup Harnessed Agentic RL
Nový přístup Harnessed Agentic RL, který představili výzkumníci z Microsoft Research Asia, přináší zásadní změnu v tom, jakým způsobem jsou agenti trénováni pomocí posilovaného učení. Klíčovým přínosem tohoto paradigmatu je možnost využít stejný rámec, takzvaný harness, který je následně používán i při samotném nasazení agenta do provozu. Díky tomu se agent s jeho orchestrací přímo účastní procesu učení, což zcela eliminuje potřebu znovu implementovat logiku agenta uvnitř trénovacího frameworku, což bylo u předchozích metod velmi náročné c1. Tento koncept 'harnessu' v podstatě znamená, že veškerá orchestrace – tedy způsob, jakým agent volá nástroje, spravuje paměť nebo plánuje své kroky – zůstává nedotčena. RL proces se tak stává transparentním doplňkem k existující infrastruktuře místo toho, aby byl jejími základními stavebními kameny. To umožňuje vývojářům integrovat komplexní logiku agentů do tréninku bez obav z narušením jejich funkčnosti c1. Díky tomuto přístupu je možné plně využít stávající orchestraci, která definuje interakce agenta s externími nástroji, aniž by bylo nutné upravovat vnitřní strukturu trénovacího systému. To výrazně snižuje bariéru pro vývojáře, kteří mohou nyní rychleji iterovat své modely a testovat nové strategie bez nutnosti kompletního přepsání kódu.
V rámci této iniciativy společnost Microsoft otevřela k dispozici Agent Lightning v1.0, což je kompletně přestavěný open-source framework určený pro efektivní trénování agentů. Tento nástroj umožňuje vývojářům pracovat s reálnými harnessy, čímž se zkracuje cesta od experimentálního trénování k finální aplikaci. Implementace Harnessed Agentic RL tak pomáhá překonávat bariéry spojené s komplexností trénovacích prostředí a umožňuje plynulejší integraci velkých jazykových modelů do autonomních systémů bez nutnosti zdlouhavých a chybprone procesů přeimplementace c1. Open-source dostupnost frameworku umožňuje širší komunitě experimentovat s autonomními systémy a využívat efektivní metodiky trénování, které byly dříve dostupné pouze v uzavřených laboratorních podmínkách.
Technické řešení pomocí LLM proxy
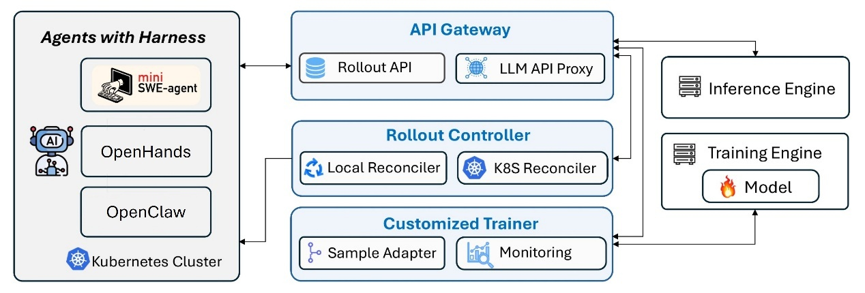
Technické řešení pomocí LLM proxy představuje jádro architektury Agent Lightning. Systém vkládá proxy server mezi samotného agenta a velký jazykový model (LLM). Agent přitom běží jako dříve: stačí přesměrovat endpoint, který dosud volal API modelu, na Agent Lightning. Díky tomu může trénovací framework sledovat a zaznamenávat modelová volání, která agent během své činnosti generuje. Tento mechanismus funguje jako transparentní vrstva, která neovlivňuje samotnou logiku rozhodování modelu, ale umožňuje systému efektivně sbírat data o interakcích v reálném čase.
Tento přístup je součástí širší struktury, kde API Gateway slouží jako kompatibilní proxy pro OpenAI a propojuje každé volání z harnessu s konkrétním rozbalením, tedy rolloutem. Jak ukazuje schéma architektury v2, systém integruje API Gateway, Rollout Controller a Customized Trainer, což umožňuje oddělit samotné spouštění agentů v Kubernetes clusteru od procesu trénování. Celý proces tak umožňuje sbírat prompty, odpovědi a logaritmické pravděpodobnosti, které jsou nezbytné pro následné učení, aniž by došlo k narušení standardního chování agenta c3. Tato modularita zajišťuje, že proces sběru dat a následné optimalizace probíhá nezávisle na samotném běhu agentů, což zvyšuje celkovou robustnost a škálovatelnost celého trénovacího procesu.
Výsledky v kódovacích úlohách
V experimentu s kódovacím agentem se model Qwen3.5-9B na benchmarku SWE-bench Verified zlepšil z původních 41,8 % na 56,4 % v metrice Pass@1, tedy o 14,6 procentního bodu. Autoři přitom využili jen asi 6 000 trénovacích vzorků z otevřeného datasetu. Tento výrazný nárůst úspěšnosti byl dosažen s relativně malým množstvím dat, což demonstruje vysokou efektivitu nového trénovacího receptu v porovnání s tradičními metodami, které vyžadují mnohem rozsáhlejší datasety.
K dosažení těchto hodnot byla sestavena komplexní testovací pipeline, která integrovala nástroje SWE-smith a mini-SWE-agent společně s modelem Qwen3.5-9B. Celý proces nebyl omezen pouze na samotné učení, ale zahrnoval i kritické předstupně kroky, jako je důsledné čištění dat a konstrukce vhodného prostředí pro běh agentů. Výzkumníci rovněž implementovali specifické ochranné mechanismy proti takzvanému reward hackingu, což zajistilo, že model skutečně řeší problém, místo aby pouze optimalizoval odměnu v systému c5. Tato komplexní pipeline byla navržena tak, aby minimalizovala šum v datech a zajistila, že model se učí skutečným řešením programátorských úloh, nikoliv pouze hledáním zkratek v systému odměn.
Optimalizace stability a odměn
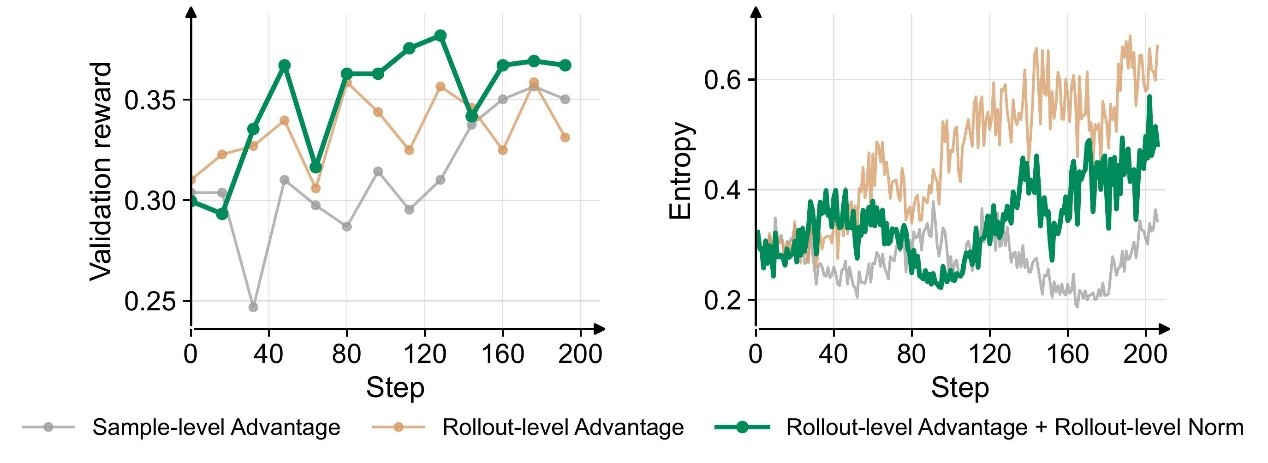
Optimalizace stability a odměn v rámci tréninku agentů byla předmětem experimentů s frameworkem Agent Lightning. Výzkumníci z Microsoft Research porovnávali způsob výpočtu advantage a normalizaci ztrátové funkce (loss). Výpočet advantage na úrovni rolloutu spolu s normalizací loss na stejné úrovni v experimentu dal vyšší validační odměnu a stabilnější entropii politiky než zpracování na úrovni jednotlivých vzorků. Tento rozdíl v přístupu k normalizaci dat ukazuje, že agregace informací na úrovni celých sekvencí akcí (rolloutů) poskytuje modelu konzistentnější signál pro učení než izolované vzorky.
Kromě vyšší odměny tato metoda výrazně stabilizuje entropii politiky během celého procesu trénování. Zatímco samostatné použití advantage na úrovni rolloutu může vést k prudkému nárůstu entropie, kombinovaná metoda udržuje hodnoty stabilnější a nižší, což zabraňuje nestabilitě modelu v průběhu učení. Grafické srovnání ukazuje, že právě synergie obou technik umožňuje modelu dosáhnout optimálního bodu výkonu, který překonává jak samotný rollout-level advantage, tak i přístupy založené na vzorcích v3. Takto stabilizovaný proces tréninku je klíčový pro predikovatelné zlepšování schopností agentů v reálných programovacích prostředích c8. Kombinace těchto dvou technik tedy vytváří synergický efekt, který umožňuje modelu konvergovat k optimálnímu řešení rychleji a s menším rizikem kolapsu politiky, což je kritické pro stabilitu velkých jazykových modelů při posilovaném učení.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Agent Lightning v1.0: A 3,500-Line Lightweight Agentic RL Framework for Training Agents with Real Harnesses – Microsoft Research — Microsoft Research Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.