
Zlatá evalační sada je kurátorovaný soubor vstupů z reálného provozu, které jsou spárovány s ověřenými očekávanými výstupy. Sada je verzována v systému Git a spouští se před každým nasazením jako regresní test chování modelu.
Využití produkčních dat poskytuje kvalitnější základ pro hodnocení než synteticky generovaná data, protože zachovávají skutečné rozložení dotazů uživatelů. Pokud například tvoří dotazy na ceny většinu provozu, měla by tato témata dominovat i v evalační sadě. Reálná data navíc odhalují specifické způsoby selhání, které by tvůrci při ručním psaní testů nemuseli předvídat, a umožňují efektivně sledovat postupný vývoj produktu v čase. Tato shoda s reálným rozložením dat je klíčová pro objektivní měření úspěchu; pokud by sada obsahovala pouze rovnoměrně rozdělená témata, mohl by model vykazovat vysoké celkové skóre, přestože by selhával v nejčastějších interakcích s uživateli. Sledování driftu, tedy postupného posunu v tom, co uživatelé od systému očekávají nebo jaké dotazy pokládají, je pak díky produkčním datům mnohem přesnější než u statických syntetických sad.
Krok za krokem k implementaci
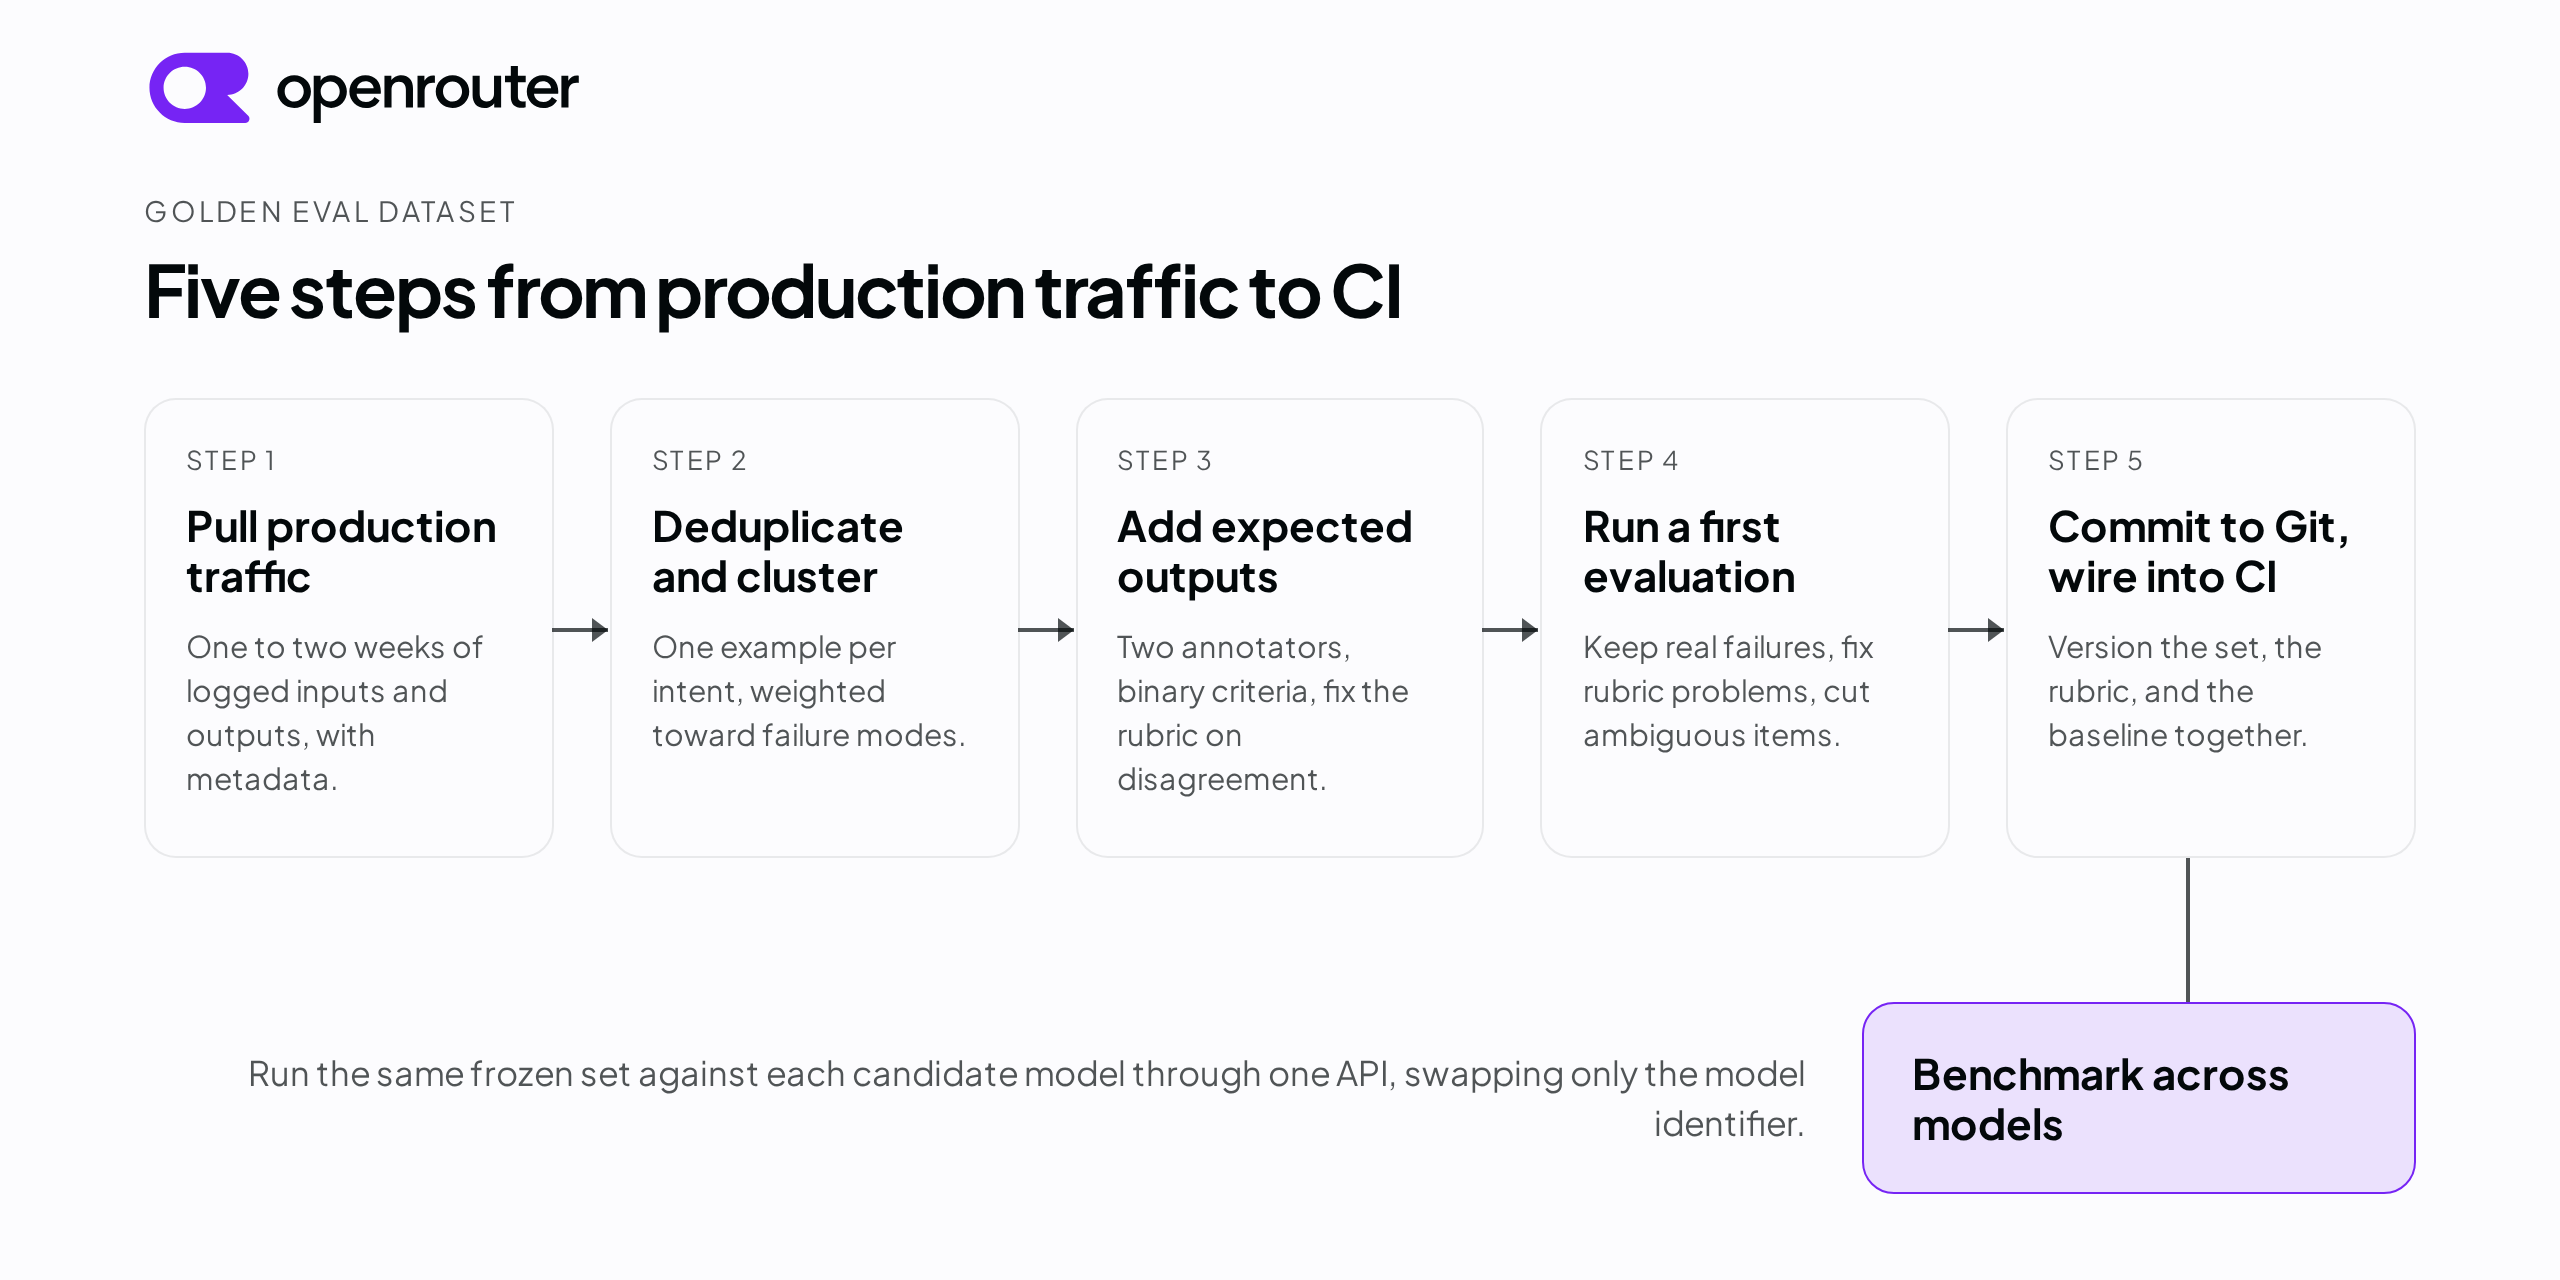
Krok za krokem k implementaci začíná procesem, který se skládá z pěti konkrétních fází. Prvním krokem je získání vzorku z reálného produkčního provozu, což v praxi znamená sběr zaznamenaných vstupů a výstupů za období jednoho až dvou týdnů. Vzhledem k tomu, že provoz v produkci bývá repetitivní, následuje druhý krok, kterým je deduplikace a shlukování dat. Teprve poté přichází třetí fáze, kdy musí kvalifikovaná osoba pro každý vybraný vstup definovat, jak by měl vypadat správný a očekávaný výstup. Sběr dat za období jednoho až dvou týdnů pomáhá zachytit přirozené kolísání provozu. Následná deduplikace a shlukování jsou nezbytné, protože uživatelé často pokládají velmi podobné otázky, což by při absenci shlukování vedlo k nadměrnému zastupování několika málo témat a neefektivnímu množství práce při ručním definování očekávaných výstupů. Definice správného výstupu kvalifikovanou osobou pak tvoří základní pravdu (ground truth), proti které se model měří.
Čtvrtý krok procesu spočívá v provedení první evaluace, při které je současný produkční model testován proti vytvořené sadě. Cílem je zanalyzovat každé selhání a následně opravit hodnoticí rubriku. Posledním krokem je uložení výsledné sady do systému Git, kde je verzována společně s prompty a kódem, který ji spouští. Celý proces se následně napojí na CI a dále se iteruje.
Metodika konzistentního hodnocení
Metodika konzistentního hodnocení vyžaduje přísný přístup k definování úspěchu, aby byly výsledky objektivní a reprodukovatelné. Autor doporučuje využívat binární kritéria, kde je každý konkrétní požadavek označen pouze jako splněn nebo nesplněn. Namísto holistických rubrik, které přidělují jedno celkové skóre, je vhodné nasadit analytické rubriky. Tyto nástroje umožňují bodovat každé kritérium zvlášť, což přináší detailnější vhled do toho, v jakých konkrétních aspektech model selhává nebo uspěje. Binární kritéria eliminují subjektivitu spojenou s odhadováním stupnice (např. 1 až 5), kde by dva hodnotitelé mohli mít odlišný pohled na to, co tvoří „střední“ kvalitu. Analytické rubriky umožňují rozkládat komplexní odpověď na dílčí aspekty – například správnost faktů, tón komunikace a dodržení formátu – a bodovat je nezávisle, což přesně lokalizuje slabiny modelu.
K zajištění vysoké kvality dat by měla podmnožina vzorků projít nezávislou anotací dvěma lidmi. V případě, že se tito hodnotitelé v posuzování shodnou, je proces stabilní, avšak při vzniknu rozporů autor doporučuje změnit přístup k problému. Neshoda mezi anotátory není vnímána jako jejich chyba, nýbrž jako indikace problému v samotné hodnoticí rubrice. Takový postup vede k postupnému zpřesňování kritérií, což v konečném důsledku zvyšuje spolehlivost celého procesu evaluace. Tento proces nezávislé anotace slouží jako kontrolní mechanismus pro validaci samotných pravidel hodnocení. Pokud dva experti na stejný vzorek aplikují stejnou rubriku a přesto dospějí k odlišným výsledkům, znamená to, že rubrika není dostatečně jednoznačná nebo obsahuje ambiguity. Opravou rubriky v těchto bodech se eliminuje prostor pro interpretaci, což zvyšuje konzistenci i při následném automatizovaném hodnocení.
Využití LLM jako soudce
Využití LLM jako soudce může být při detekci regresí dostatečně spolehlivé, pokud je proces založen na dobře navržené rubrice s binárními kritěrii a ukázkovými příklady. Míra shody s lidskými hodnotiteli se však liší v závislosti na konkrétní úloze, zvoleném modelu i samotné rubrice. Z tohoto důvodu je nezbytné hodnoticí modely kalibrovat pomocí sady příkladů, které byly předem označeny lidmi, aby bylo možné výsledné skóre považovat za validní. Klíčem k úspěchu je použití tzv. ukázkových příkladů (anchor examples), které hodnoticí modely v promptu definují, co přesně znamená „splněno“ a „nesplněno“. Kalibrace na lidsky označených datech pak umožňuje kvantifikovat, jak moc se LLM soudce shoduje s lidmi, a určit hranici spolehlivosti, při které lze automatickému hodnocení v rámci CI/CD pipeline důvěřovat.
Spolehlivost soudců kolísá i při změně samotného náhodného seedu. Jedna studie, která 100krát testovala tři různé hodnoticí modely na otázkách z BIG-Bench Hard, zaznamenala rozptyl spolehlivosti mezi nimi od 0,167 do 1,00. Jediný běh soudce proto nelze brát jako jistotu, zejména u rizikových rozhodnutí. K zamezení tendence preferovat vlastní odpovědi je doporučeno použít k hodnocení jiný model, než který se právě testuje.
Srovnávání různých modelů
Srovnávání různých modelů lze realizovat prostřednictvím služby OpenRouter, která umožňuje využívat stejné tělo požadavku kompatibilní s OpenAI napříč celým katalogem dostupných modelů. U kandidátů, kteří sdílejí stejné rozhraní a podporují parametry použité v požadavku, lze modely porovnat změnou identifikátoru konkrétního modelu, například z GPT na Claude, a novým spuštěním testovacího harnessu. Pokud se modely liší v délce kontextu, podpoře nástrojů nebo podporovaných parametrech, je u každého kandidáta potřeba počítat s určitou integrační prací.
OpenRouter však upozorňuje, že tato jednoduchost platí pouze pro kompatibilní systémy. Pokud se jednotlivé modely liší v délce kontextového okna, podpoře externích nástrojů nebo v seznamu podporovaných parametrů, je nutné počítat s určitou mírou integrační práce pro každého konkrétního kandidáta.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Building a Golden Eval Dataset from Production Traffic — OpenRouter Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.