
NVIDIA zveřejnila měření, při němž se porovnával provoz velkého jazykového modelu (LLM) se zapnutými a vypnutými důvěrnými výpočty. Test proběhl s modelem DeepSeek-R1 na osmi grafických procesorech B200. Podle NVIDIA si režim důvěrných výpočtů, zkráceně CC, udržel 96,1 až 98,2 % propustnosti výstupních tokenů oproti běhu bez tohoto režimu. Propustnost se přitom vyjadřuje jako počet výstupních tokenů za sekundu. Měřilo se při souběhu od jednoho do šestnácti požadavků, tedy při různém počtu požadavků zpracovávaných současně. Společnost zároveň uvádí, že latence na jeden token se napříč těmito úrovněmi souběhu zvýšila o 1,2 až 4,3 %. Jde o údaje z vlastního kontrolovaného srovnání, které uvádí sama NVIDIA.
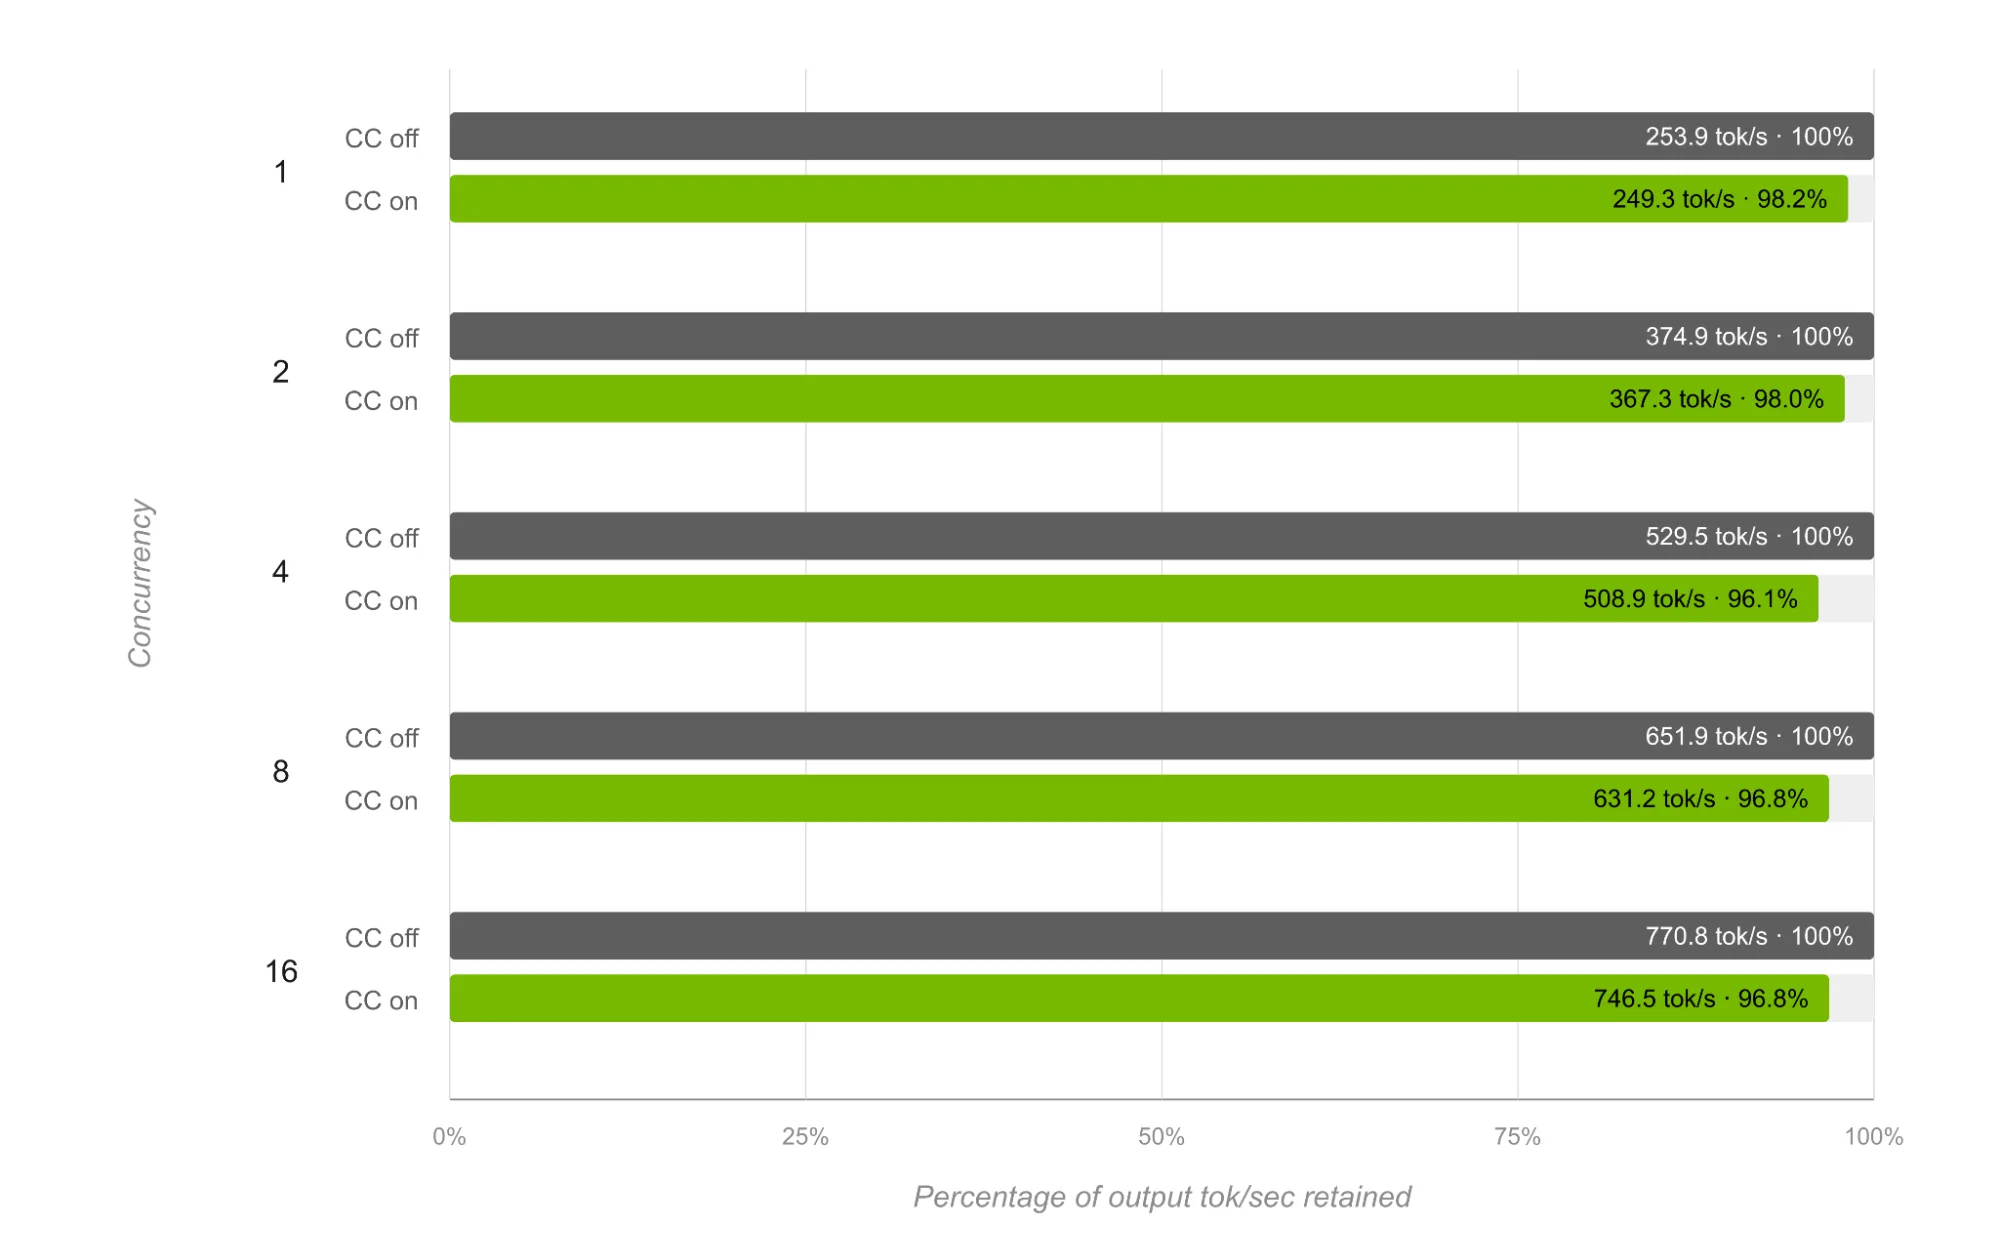
Graf znázorňuje srovnání po jednotlivých úrovních souběhu. Běh bez CC je v něm normalizován na 100 % a běh se zapnutým CC se k němu vztahuje. Při souběhu 1, 2, 4, 8 a 16 požadavků dosáhl režim CC postupně 98,2 %, 98,0 %, 96,1 %, 96,8 % a 96,8 % výchozí propustnosti. Nejnižší hodnota, tedy 96,1 %, připadá na souběh čtyř požadavků. Zapnutí ochrany tak v nejhorším případě ubralo necelých čtyři procenta z výchozí propustnosti, v nejlepším necelá dvě procenta. Měření provedl tým výkonového inženýrství NVIDIA na hardwarové a softwarové konfiguraci popsané v původním článku. Výsledky platí pro tento konkrétní test a uvedený rozsah souběhu.
Latence na token zůstala pod 5 %
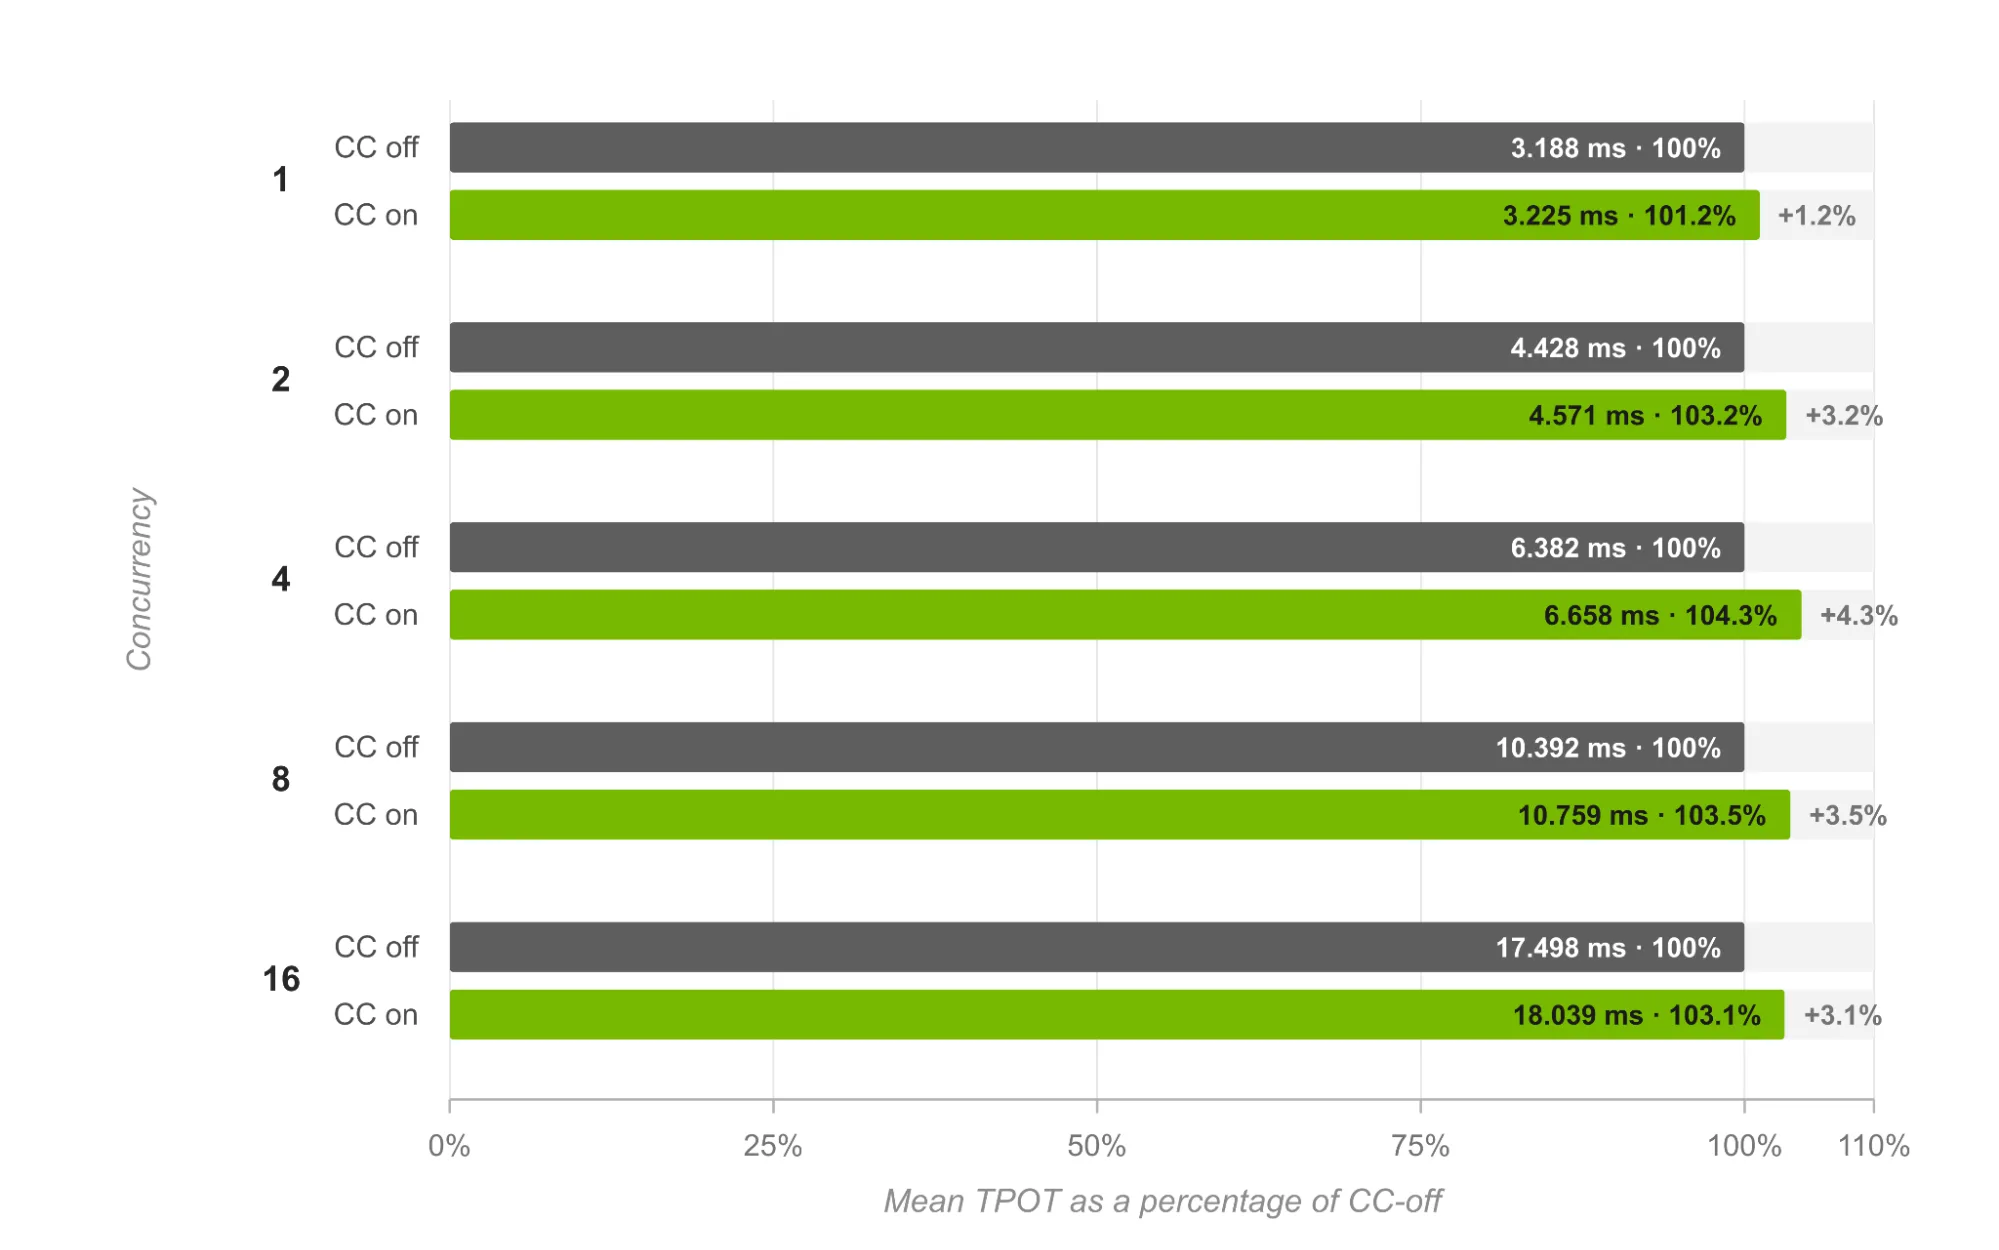
Latence na jeden výstupní token, v angličtině označovaná TPOT, byla se zapnutým režimem důvěrných výpočtů vyšší o 1,2 až 4,3 % než v základním běhu. Veličina TPOT udává, jak dlouho v průměru trvá vygenerování jednoho výstupního tokenu, a platí u ní, že nižší hodnota znamená lepší výsledek. Tak to vyplývá z měření, které provedl tým výkonového inženýrství NVIDIA. Společnost k tomu uvádí, že na osmi grafických procesorech B200 zůstal tento přírůstek pod 5 %. Měření se týkalo souběhu od jednoho do šestnácti požadavků. Jde o výsledek, který zveřejnila sama NVIDIA, nikoli o nezávislé ověření.
Graf znázorňuje průměrnou latenci na token při souběhu 1, 2, 4, 8 a 16 požadavků. Běh bez důvěrných výpočtů je v něm normalizován na 100 %. Se zapnutým režimem dosáhla latence postupně 101,2 %, 103,2 %, 104,3 %, 103,5 % a 103,1 % této hodnoty. Naměřené průměrné hodnoty se pohybovaly od 3,225 do 18,039 milisekundy na token. Nejvyšší relativní přírůstek, 4,3 %, vyšel stejně jako nejnižší propustnost při souběhu čtyř požadavků. Podle NVIDIA si konfigurace s podporou důvěrných výpočtů v knihovně TensorRT LLM udržela nárůst latence pod 5 %. Ta podpora se týká zabezpečeného přesunu dat, automatického ladění a komunikace mezi více grafickými procesory. Údaje platí pro tento konkrétní test s modelem DeepSeek-R1.
Jak se měřilo
NVIDIA popisuje, že výkonnostní dopad důvěrných výpočtů (CC) izolovala kontrolovaným srovnáním dvou stavů. Stejnou zátěž spustila jednou s vypnutými důvěrnými výpočty, označenými CC off, a podruhé se zapnutými, tedy CC on. Model, hardware, verze frameworku, délky sekvencí, paralelismus i souběh zůstaly v obou případech beze změny. Podle popisu tak byl jedinou proměnnou právě stav CC. Takové uspořádání umožňuje přičítat rozdíly ve výsledcích zapnutí důvěrných výpočtů, a ne jiným změnám v nastavení testu. Kdyby se mezi oběma běhy změnila například verze frameworku nebo počet souběžných požadavků, nebylo by možné poznat, co za rozdíl skutečně odpovídá.
Výsledky se vyhodnocovaly na každé úrovni souběhu zvlášť a počítaly se dvě veličiny. První je podíl zachované propustnosti: výstupní tokeny za sekundu se zapnutými důvěrnými výpočty se vydělí hodnotou ze základního běhu a výsledek se vynásobí stem. Druhou veličinou je procentní přírůstek latence na jeden výstupní token (TPOT). Ten se spočítá jako podíl hodnoty TPOT při CC on a při CC off, od něhož se odečte jednička, a opět se přepočte na procenta. Hodnota 104,3 % v grafu latence tedy odpovídá přírůstku 4,3 %. Podle NVIDIA mohou výkonnostní týmy tato měření použít k vyčíslení toho, jak velká část základní hodnoty z běhu bez CC zůstane zachována po zapnutí CC u cílové zátěže.
Proč vzniká režie a jak ji omezují
Podle NVIDIE vzniká režie tím, že zabezpečené spouštění mění předpoklady, na nichž stojí přesuny v paměti, časování, plánování i komunikace mezi více GPU. Inferenční frameworky přitom s těmito předpoklady původně počítaly, když běžely v prostředí bez důvěrných výpočtů. Pokud se běhové prostředí nepřizpůsobí, objeví se výkonová režie. NVIDIA z toho vyvozuje, že se inferenční framework a prostředí důvěrných výpočtů musí optimalizovat společně, má-li výkon zůstat vysoký. Samotné zapnutí ochrany tedy nestačí. Podstatné je také to, jak dobře se na ni software přizpůsobí. Jde o výklad samotného dodavatele, který ho uvádí ve svém technickém blogu.
Jeden konkrétní příklad se týká přenosů z hostitele do zařízení. Na B200 v režimu CC procházejí přes softwarově šifrovaný mezilehlý buffer (bounce buffer), protože GPU nemůže přímo číst chráněnou paměť důvěrného virtuálního stroje. Data tedy neputují přímo z chráněné paměti do GPU, ale přes tento mezikrok. Proti tomu TensorRT LLM u dotčených cest volí stránkovatelnou (pageable) paměť místo bezpodmínečného použití pinned paměti. NVIDIA toto rozhodnutí označuje za opatření proti režii u přenosů z hostitele do zařízení.
Opačný směr, tedy přenos ze zařízení do hostitele, řeší jiné opatření. Opakované zpětné čtení tokenů a dat pro vzorkování přesouvá TensorRT LLM do asynchronního workeru. Chráněné kopírování tak podle NVIDIE neblokuje hlavní plánovač během dekódování. Obě úpravy ukazují stejný princip: místo aby se výpočet zastavoval kvůli zabezpečenému kopírování, upravuje se způsob, jakým framework s pamětí zachází, a kdy se kopírování provádí.
Omezení výsledků a co z nich plyne
Výsledky je třeba číst s vědomím několika omezení. Pocházejí z jediné zvolené zátěže: vstup o délce 32K, výstup 1K a souběh od jednoho do šestnácti požadavků. Měření i jeho zveřejnění navíc zajistila společnost NVIDIA, tedy výrobce, který o výkonu svých technologií sám informuje na vlastním technickém blogu. Jde proto o tvrzení dodavatele, nikoli o nezávislé ověření. Testovaný model byl nvidia/DeepSeek-R1-0528-NVFP4, spuštěný v TensorRT LLM s backendem PyTorch a s nastavením TP=8, EP=1, PP=1. Mezipaměť KV používala formát FP8. Jiná kombinace modelu, délek sekvencí nebo paralelismu může dopadnout jinak.
Autoři sami upozorňují, že viditelnost režie důvěrných výpočtů závisí na charakteru zátěže. Zvolenou zátěž tedy vybrali tak, aby režii bylo možné zachytit. Z toho plyne, že výkon jiných úloh se z těchto čísel odvodit nedá a je nutné ho změřit zvlášť. Blog k tomu doporučuje konkrétní postup: zapnout důvěrné výpočty, ověřit prostředí pomocí atestace a porovnat běh se zapnutou i vypnutou ochranou. Měření má přitom proběhnout přesně na té zátěži, kterou chce provozovatel skutečně obsluhovat. Praktický závěr zní, že číslo kolem 96 % je dobrým ukazatelem pro testovanou konfiguraci, nikoli zárukou pro každé nasazení.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Enabling Private High-Performance Production AI Inference with NVIDIA Confidential Computing | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.