
Agent může projít všemi deterministickými testy a přesto dát špatnou odpověď. Podle návodu OpenRouter například zavolá správný nástroj pro vyhledání objednávky, načte správnou politiku vrácení peněz a ve finální zprávě pak vynechá lhůtu, na které zákazníkovi nejvíc záleží. Autoři proti tomu navrhují techniku LLM-as-a-judge: druhý jazykový model přečte výstup testovaného agenta, poměří ho s kritérii zapsanými běžnou řečí a vrátí skóre. Návod ukazuje zapojení do testů v nástroji Ori Eval a také hranice celé metody.
Druhý model jako recenzent
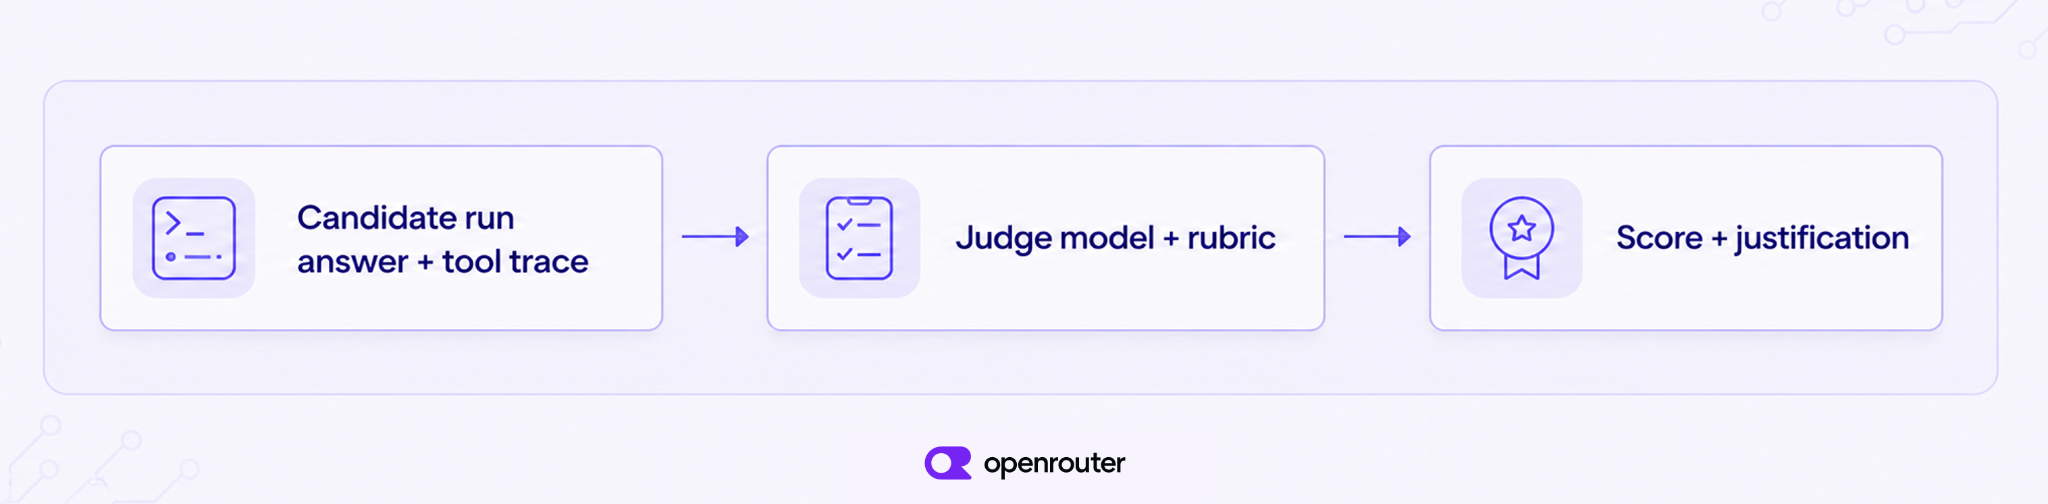
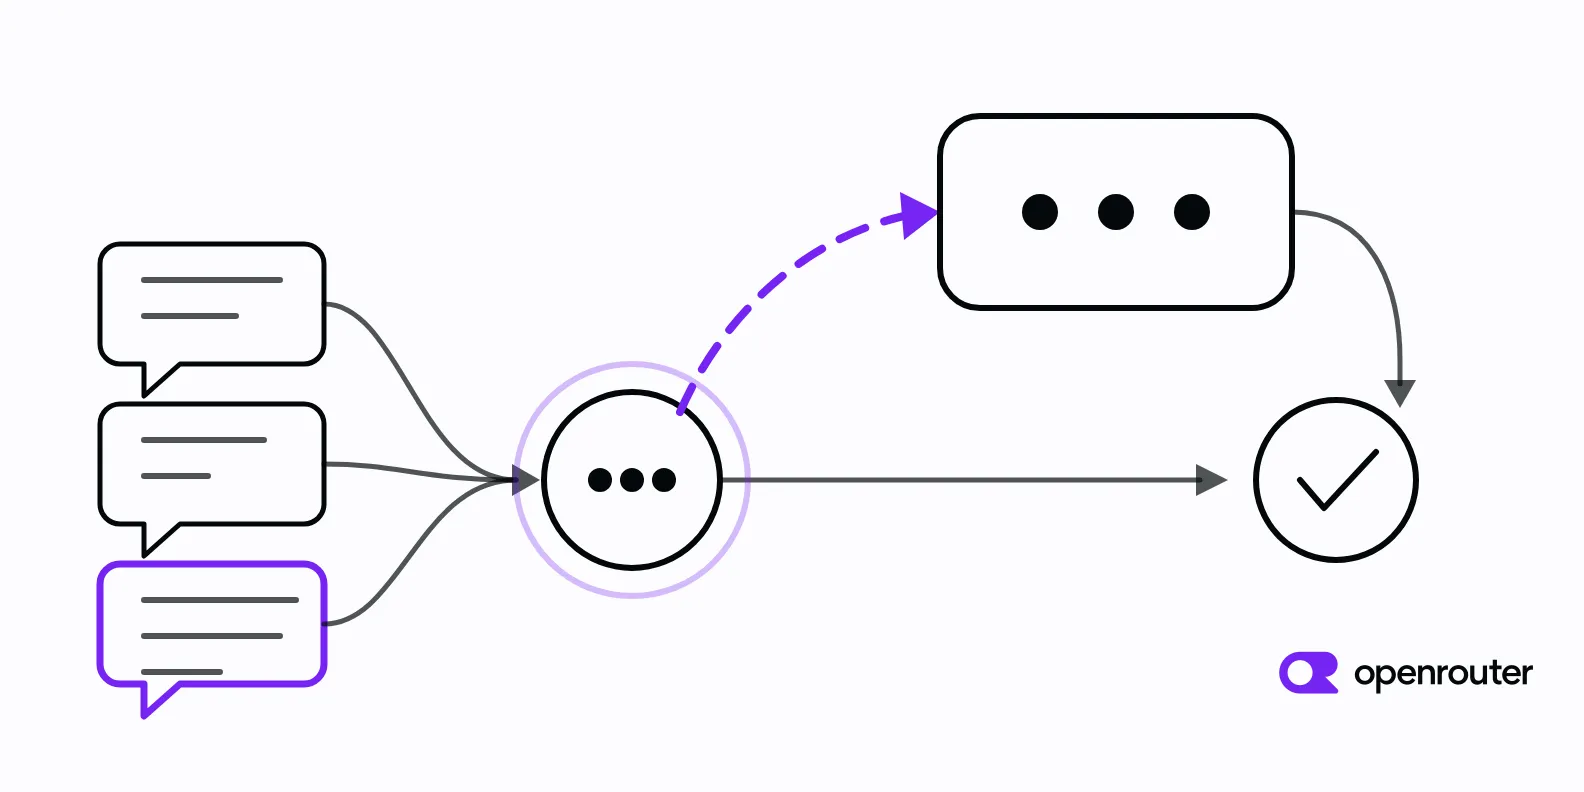
Princip je jednoduchý. Nejdřív proběhne běh kandidáta, tedy testovaného agenta. Jeho odpověď a případné relevantní výsledky nástrojů dostane soudce, tedy hodnoticí model. Ten výstup posoudí podle rubriky, což je sada kritérií, kterou předem napsal člověk, a vrátí skóre. Pokud klesne pod nastavený práh, evaluace selže. Podle autorů tak vzniká opakovatelný způsob, jak testovat otevřené odpovědi, které lze správně vyjádřit několika způsoby. Rubrika přitom nahrazuje hledání jediné správné věty: popisuje, co má dobrá odpověď splňovat, a nechává prostor pro různé formulace. Diagram ve zdroji ukazuje cestu od běhu kandidáta s odpovědí a stopou nástrojů přes soudce s rubrikou ke skóre a zdůvodnění.
Aby hodnocení nebylo zkreslené, doporučují autoři dvě opatření. Testovaný model a soudce mají podle nich pokud možno běžet na různých modelech. Odvolávají se na studii Zheng a kol. z roku 2023, která popisuje tři sklony hodnoticích modelů: upřednostňují odpovědi, které sami vygenerovali, záleží jim na pozici, v níž je odpověď předložena, a delší odpovědi zvýhodňují bez ohledu na kvalitu. Druhé opatření se týká vstupu. Soudce má vidět jen viditelnou odpověď a nezbytné výsledky nástrojů. Kdyby znal skryté uvažování kandidáta, hodnocení by přestalo být nezávislé.
Kdy soudce nasadit a kdy ne
Průvodce rozlišuje tři režimy. Při pointwise hodnocení soudce dostane jeden výstup a rubriku; hodí se k hlídání kvalitativní hranice v průběžné integraci (CI) nebo ke kontrole vzorků z provozu. Pairwise režim srovnává dva výstupy a slouží k porovnání modelů, promptů či verzí agenta. Reference-based režim přidává důvěryhodnou referenci a kontroluje věcné pokrytí oproti ověřené odpovědi nebo zdroji. Samotný návod používá pointwise hodnocení, protože každý běh buď požadovanou úroveň splní, nebo ne.
Soudce se hodí tam, kde je požadavek jasný, ale neexistuje jediný přesný výstup. Špatnou volbou je naopak tehdy, když lze výsledek ověřit přímo. Strukturu JSON má podle autorů hlídat validátor schématu, aritmetiku kalkulačka a argumenty nástrojů či vedlejší účinky unit testy. Pravidla, která musí vždy zablokovat akci, mají zůstat deterministická. Soudce tedy klasické testy nenahrazuje. Doplňuje je tam, kde význam odpovědi kódem změřit nelze.
Ukázka v nástroji Ori Eval
Ori Eval spouští evaluace jako soubory v TypeScriptu v testovacím runneru Bun. Hlavní práci nesou dvě funkce. setupJudge() vytvoří samostatného hodnotícího agenta na vlastním modelu, odděleném od testovaného. Tím se v praxi naplňuje dříve zmíněné doporučení nemíchat obě role na jednom modelu. Funkce autoEvals() pak ohodnotí běh kandidáta podle zadaných kritérií. Ukázkový test se ptá agenta, zda lze vrátit digitální objednávku zadanou před deseti dny. Kritéria žádají, aby odpověď uvedla čtrnáctidenní lhůtu, odpověděla přímo a nevymýšlela výjimky.
Test kombinuje dvě vrstvy. Aserce run.tool() a run.toComplete() ověřují pozorovatelné kroky, tedy že agent zavolal nástroj lookup_refund_policy a běh doběhl. Význam hotové odpovědi posoudí autoEvals(). Jednoduše řečeno: první vrstva kontroluje, co agent udělal, druhá, co řekl. Parametr minScore určuje nejnižší skóre, které ještě projde. Hodnota 0,8 z ukázky je podle autorů jen výchozí bod a je třeba ji kalibrovat na vlastních ručně ohodnocených odpovědích. Co jde zkontrolovat kódem, kontroluje kód; zbytek připadne soudci.
Příkaz ori eval –report eval-report.md najde soubory *.eval.ts pod aktuálním adresářem, spustí je přes bun test a skončí s jeho návratovým kódem. Neúspěšná evaluace tak shodí celý příkaz a volba –report navíc zapíše report v Markdownu, který lze prohlédnout vedle ostatních výstupů testů. Evaluace posílají skutečné požadavky na modely, proto autoři radí držet je v samostatné CI úloze spouštěné ručně, podle plánu nebo před vydáním, ne při každém běhu unit testů. V CI se klíč OPENROUTER_API_KEY uloží jako tajný údaj repozitáře a příkaz ori login pak není potřeba.
Srovnání modelů
Při srovnávání modelů zůstávají kritéria i soudce stejné, mění se jen kandidát. Model se předává přes setupAgent({ model }), takže každá iterace smyčky testuje jiný model proti téže rubrice. Funkce candidateModels() vrací identifikátory modelů z živého katalogu a umí je filtrovat podle ceny, délky kontextu, požadovaných parametrů, vstupních modalit, indexů kvality nebo toho, zda model brzy zanikne. Ukázka bere pět modelů s horní hranicí ceny promptu. Pro regresní testy autoři radí model uvést explicitně, aby se při změně katalogu neporovnávala jiná sada, a použít assertModelIsLive(slug), aby test při zmizení modelu z katalogu selhal s jasnou hláškou.
Jak věřit skóre
Spolehlivost soudce se podle průvodce ověřuje na malé sadě příkladů z realistických interakcí agenta. Ta má obsahovat jasné úspěchy, jasná selhání i hraniční případy. Lidé odpovědní za kvalitu je ohodnotí jako první a teprve pak se jejich rozhodnutí porovnají s verdikty soudce. Kalibraci je nutné opakovat při změně soudce, rubriky nebo dat. U pairwise hodnocení autoři doporučují srovnání zopakovat s prohozeným pořadím odpovědí, aby se odhalil vliv pozice. Pokud výsledek závisí na tom, která odpověď stojí první, nelze mu bez výhrad věřit.
S kolísáním výsledků je třeba počítat. Uložení přesné rubriky a testovacích dat do verzovacího systému a zaznamenání modelů, verze nástroje, směrování a nastavení generování sice změny zpětně dohledatelnými, ale výstup modelu deterministickým neudělá. Podle průvodce může být malý pohyb skóre poblíž prahu běžný šum. Silnějším důkazem regrese je až opakovaný pokles na reprezentativní sadě testů. Jediný propad pod 0,8 tedy ještě nemusí znamenat zhoršení agenta.
Hodnocení soudcem také něco stojí, protože každý vyhodnocený běh přidává další požadavky na model. Náklady rostou s počtem testů, kandidátních modelů i dimenzí rubriky. Autoři navrhují spouštět deterministické kontroly při každém commitu a evaluace s modelem jen podle plánu či před vydáním. Dále doporučují vzorkovat reprezentativní produkční stopy místo hodnocení všeho, použít jedno zaměřené volání soudce místo několika překrývajících se kritérií, při běžných regresích testovat menší sadu kandidátů a posílat soudci jen kontext, který pro rubriku potřebuje.
Je dobré vědět, co text neprokazuje. Jde o návod, nikoli o měření: neuvádí, jak často se soudce shoduje s lidmi, kolik evaluace stojí v penězích ani jak velký je šum skóre u konkrétních modelů. Práh 0,8 je jen ukázka. Praktický první krok z návodu tedy je sestavit malou sadu lidmi ohodnocených odpovědí s jasnými úspěchy, selháními i hraničními případy a podle ní teprve nastavit minScore. Teprve pak má smysl nechat soudce hlídat kvalitu a jeho skóre číst s vědomím, že malé výkyvy nejsou automaticky důkazem zhoršení.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- LLM-as-a-Judge: Score AI Agent Outputs Automatically — OpenRouter Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.