
Společnost Anthropic představila svůj nejnovější model Claude Haiku 5.5, který je navržen jako rychlé a cenově dostupné řešení pro uživatele. Tento nový model se zaměřuje na efektivitu a nízké náklady, což z něj činí dostupnou alternativu pro různé typy úloh vyžadujících rychlou odezvu. Představení modelu potvrzuje dřívější sliby společnosti ohledně rozvoje této řady, která má sloužit jako lehčí varianta v rámci jejich nabídky velkých jazykových modelů. Tento model představuje strategický krok společnosti k rozšíření její nabídky o nástroj, který kombinuje vysokou rychlost s velmi nízkými provozními náklady pro širokou škálu aplikací.
Z hlediska nákladů se Claude Haiku 5.5 v rámci limitu do 100 000 tokenů cenově shoduje s modelem GPT-6 Luna od společnosti OpenAI. Podle informací zveřejněných na blogu Simona Willisona činí cena za milion vstupních tokenů 0,10 USD, zatímco za milion výstupních tokenů platí uživatelé 0,50 USD. Do hranice 100 000 tokenů je tedy cena obou modelů stejná.
Srovnání cen s GPT-6 Luna
Srovnání cen s GPT-6 Luna ukazuje, že pokud se pracovní úlohy vejdou do limitu 100 000 tokenů, je model Haiku cenově shodný s Lunou. V tomto konkrétním rozsahu přitom Haiku vykazuje vyšší skóre v benchmarcích, což z něj činí atraktivnější volbu pro menší objemy dat. Autor analýzy však upozorňuje, že situace se zásadně mění při překročení této hranice, kdy se model Luna jeví jako mnohem výhodnější alternativa pro uživatele s náročnějšími požadavky na délku textu. Díky těmto lepším výsledkům v testech je Haiku v tomto specifickém cenovém pásmu efektivnější volbou než Luna.
Když objem dat překročí 100 000 tokenů, cena za model Haiku 5.5 pětinásobně vzroste na 0,50 USD za vstup a 2,50 USD za výstup. Pro srovnání u modelu Luna dochází k cenovému nárůstu až při dosažení 272 000 tokenů, přičemž výsledná cena je nižší a činí 0,20 USD za vstup a 0,75 USD za výstup. Tato odlišná struktura cenové politiky výrazně ovlivňuje celkové náklady při zpracování rozsáhlých kontextů, kde Luna nabízí ekonomicky příznivější podmínky. Tento pětinásobný nárůst ceny u modelu Haiku 5.5 představuje kritický bod pro vývojáře, kteří pracují s rozsáhlými dokumenty nebo dlouhými konverzacemi. Zatímco model Luna od OpenAI udržuje relativně stabilní ceny až do mnohem vyššího limitu 272 000 tokenů, u Haiku dochází k prudkému skoku v nákladech již při překročení první hranice. V praxi to znamená, že pro analýzu velmi dlouhých textů bude Luna ekonomicky mnohem udržitelnější volbou, protože její nárůst ceny je mnohem mírnější a nastává později.
Skrytý nárůst nákladů
Skrytý nárůst nákladů se u modelu Haiku 5.5 projevuje především skrze implementaci nového tokenizéru, který je méně úsporný než jeho předchozí verze. Podle analýzy autora, který k ověření využil svůj nástroj Claude Token Counter, dochází při zpracování stejného dlouhého promptu k výraznému rozdílu v počtu spotřebovaných jednotek. Tento technický aspekt ovlivňuje efektivitu zpracování textu a přímé náklady na provoz modelu pro koncového uživatele.
Konkrétní měření ukázalo, že model Haiku 5.5 spotřebuje zhruba 1,25krát více tokenů ve srovnání s verzí Haiku 4.5. Autor takto vyšší spotřebu interpretuje jako skrytý nárůst ceny, protože stejný vstupní text vyžaduje více výpočetních jednotek, což v konečném součtu zvyšuje celkové náklady na generování odpovědí. Tato změna v tokenizaci tak fakticky zvyšuje cenu za zpracování dat, i když základní ceník může zůstat stejný. Tokenizace je proces rozdělení textu na menší jednotky, které model zpracovává. Pokud je tokenizér méně úsporný, znamená to, že stejné slovo nebo frázi rozdělí na více tokenů než předchozí verze. V případě přechodu z verze 4.5 na 5.5 tak uživatel platí za více jednotek i při zachování stejného množství vstupního textu. Tento jev vytváří efektivní cenovou bariéru, která není viditelná v oficiálním ceníku za milion tokenů, ale projevuje se přímo v fakturaci za konkrétní dotazy.
Funkce uvažování a její nastavení
U nového modelu Haiku podle autora blogu Simona Willisona nelze uvažování vypnout. Výchozí úroveň uvažování je nastavena na střední hodnotu.
Pro nastavení uvažování lze využít parametr thinking_effort. Autor v rámci svých testů, například při generování SVG obrázku pelikána na jízdném kole, zkoumal pět různých úrovní nastavení. Tyto úrovně jsou označeny jako low, medium, high, xhigh a max, tedy nízká, střední, vysoká, extra vysoká a maximální.
Praktické testování generování
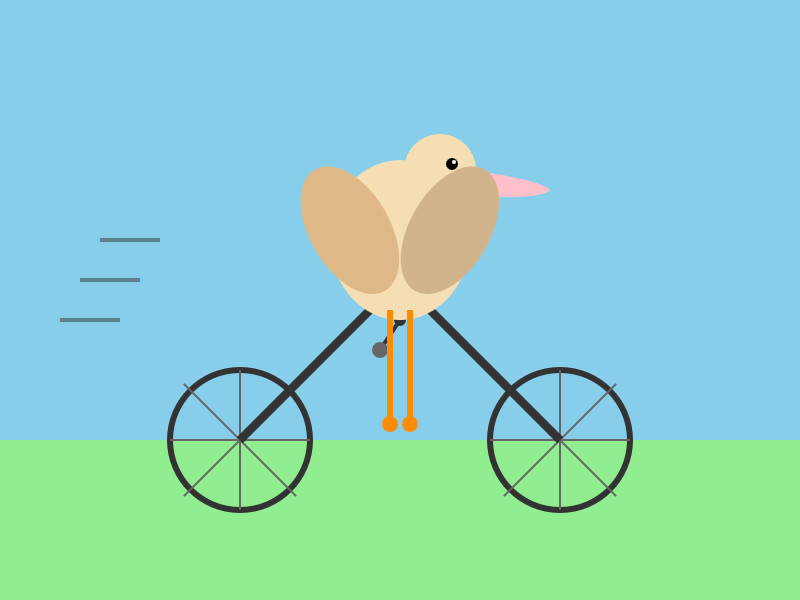
Praktické testování generování ukázalo, jak různé úrovně uvažování ovlivňují časovou náročnost a náklady u konkrétních úloh. Simon Willison v rámci svých experimentů nechal model generovat SVG obrázek pelikána na kole, přičemž u nejnižší úrovně úsilí proces trval 7 sekund a stál 0,0936 centu. Tento přístup demonstruje schopnost modelu rychle vyprodukovat základní výstup při minimálních nákladech, což je užitečné pro jednoduché požadavky, kde není vyžadována hluboká analýza struktury obrázku. v1
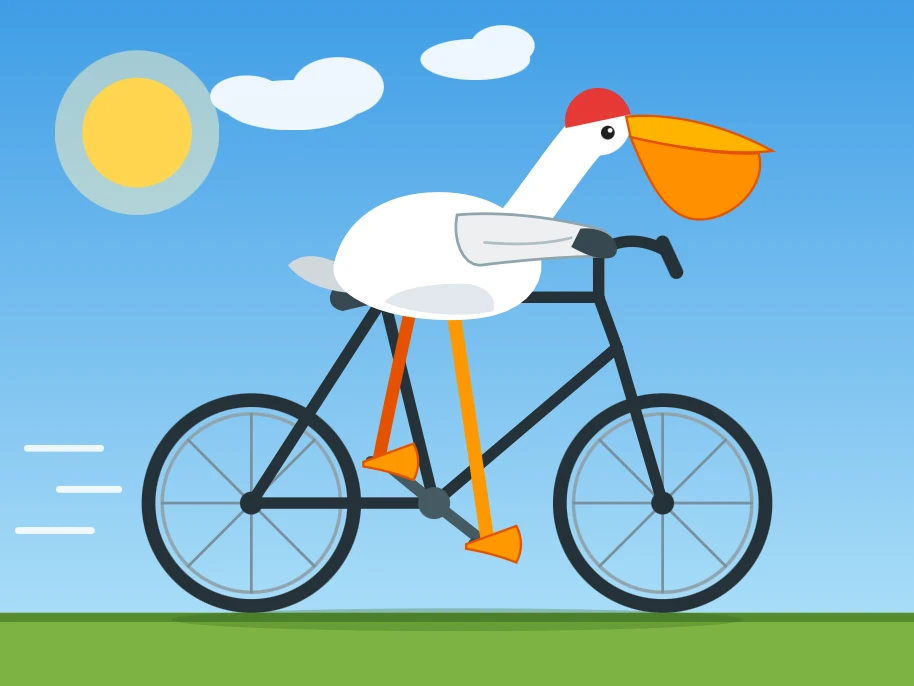
Zcela odlišné výsledky přineslo nastavení na maximální úroveň, kdy generování stejného motivu trvalo 5 minut a 9 sekund. Náklady se v tomto případě zvýšily na 3,3826 centu. V tomto režimu model vygeneroval uvažovací stopu, která začíná konstatováním, že jde o klasický test s pelikánem na kole. Srovnání nejnižší a nejvyšší úrovně ukazuje, že maximální úroveň úsilí vyžaduje výrazně více času i peněz než nejnižší: čas generování vzrostl ze 7 sekund na více než 5 minut. Uvažovací stopa v tomto režimu ukazuje povědomí modelu o tom, že jde o benchmark.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Claude Haiku 5.5 — Simon Willison's Weblog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.