
O víc než dvě hodiny rychleji
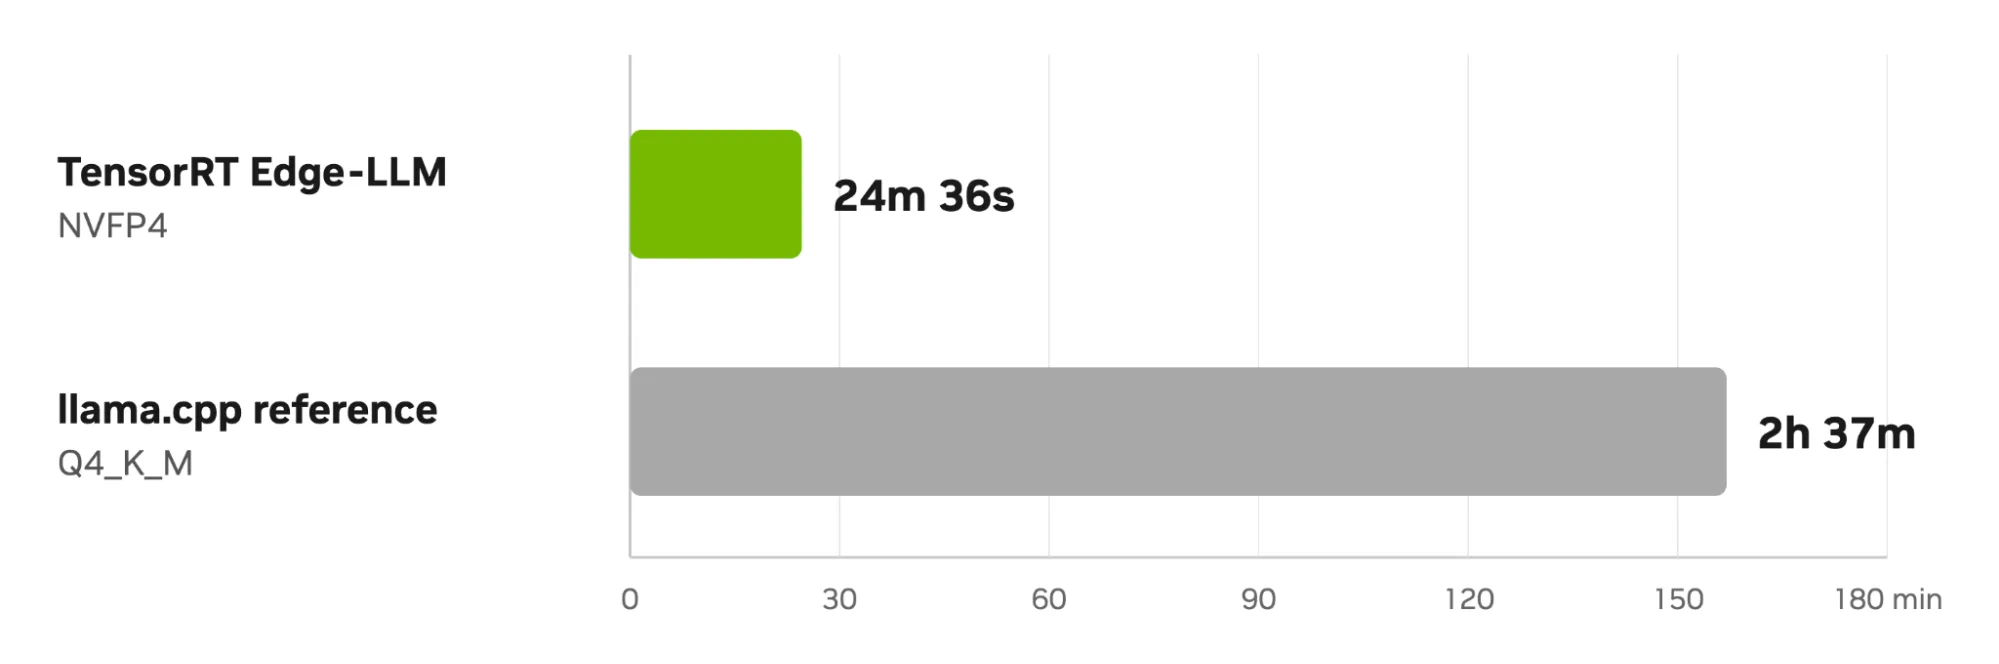
Jedno malé zařízení zvládlo za necelou půlhodinu práci, kterou referenční řešení dělalo víc než dvě a půl hodiny. NVIDIA uvádí, že její runtime TensorRT Edge-LLM s modelem Qwen3.6-27B na jednom vývojářském kitu Jetson AGX Thor dokončil všech 1 007 kroků výkonnostní zátěže benchmarku MLPerf Inference v6.1 Edge Agentic za 24 minut a 36 sekund. Referenční běh s llama.cpp, který zveřejňuje konsorcium MLCommons, trval 2 hodiny a 37 minut. Podle autorů tedy jde o zrychlení 6,4krát. Rozdíl představuje přes dvě hodiny času. Pro představu: při prostém přepočtu na jeden krok vychází u řešení NVIDIE zhruba 1,5 sekundy, u reference kolem 9,4 sekundy. Jde jen o průměr spočtený z celkových časů, ne o zveřejněnou metriku. Výsledek pochází z blogu samotné NVIDIE, nikoli z nezávislého ověření. Přesto je zajímavý tím, že nemíří na krátké odpovědi chatbota, ale na agenta, který opakovaně volá nástroje a vrací se k rozpracované práci. Graf ukazuje celkový čas dokončení výkonové zátěže.
Co benchmark vlastně měří
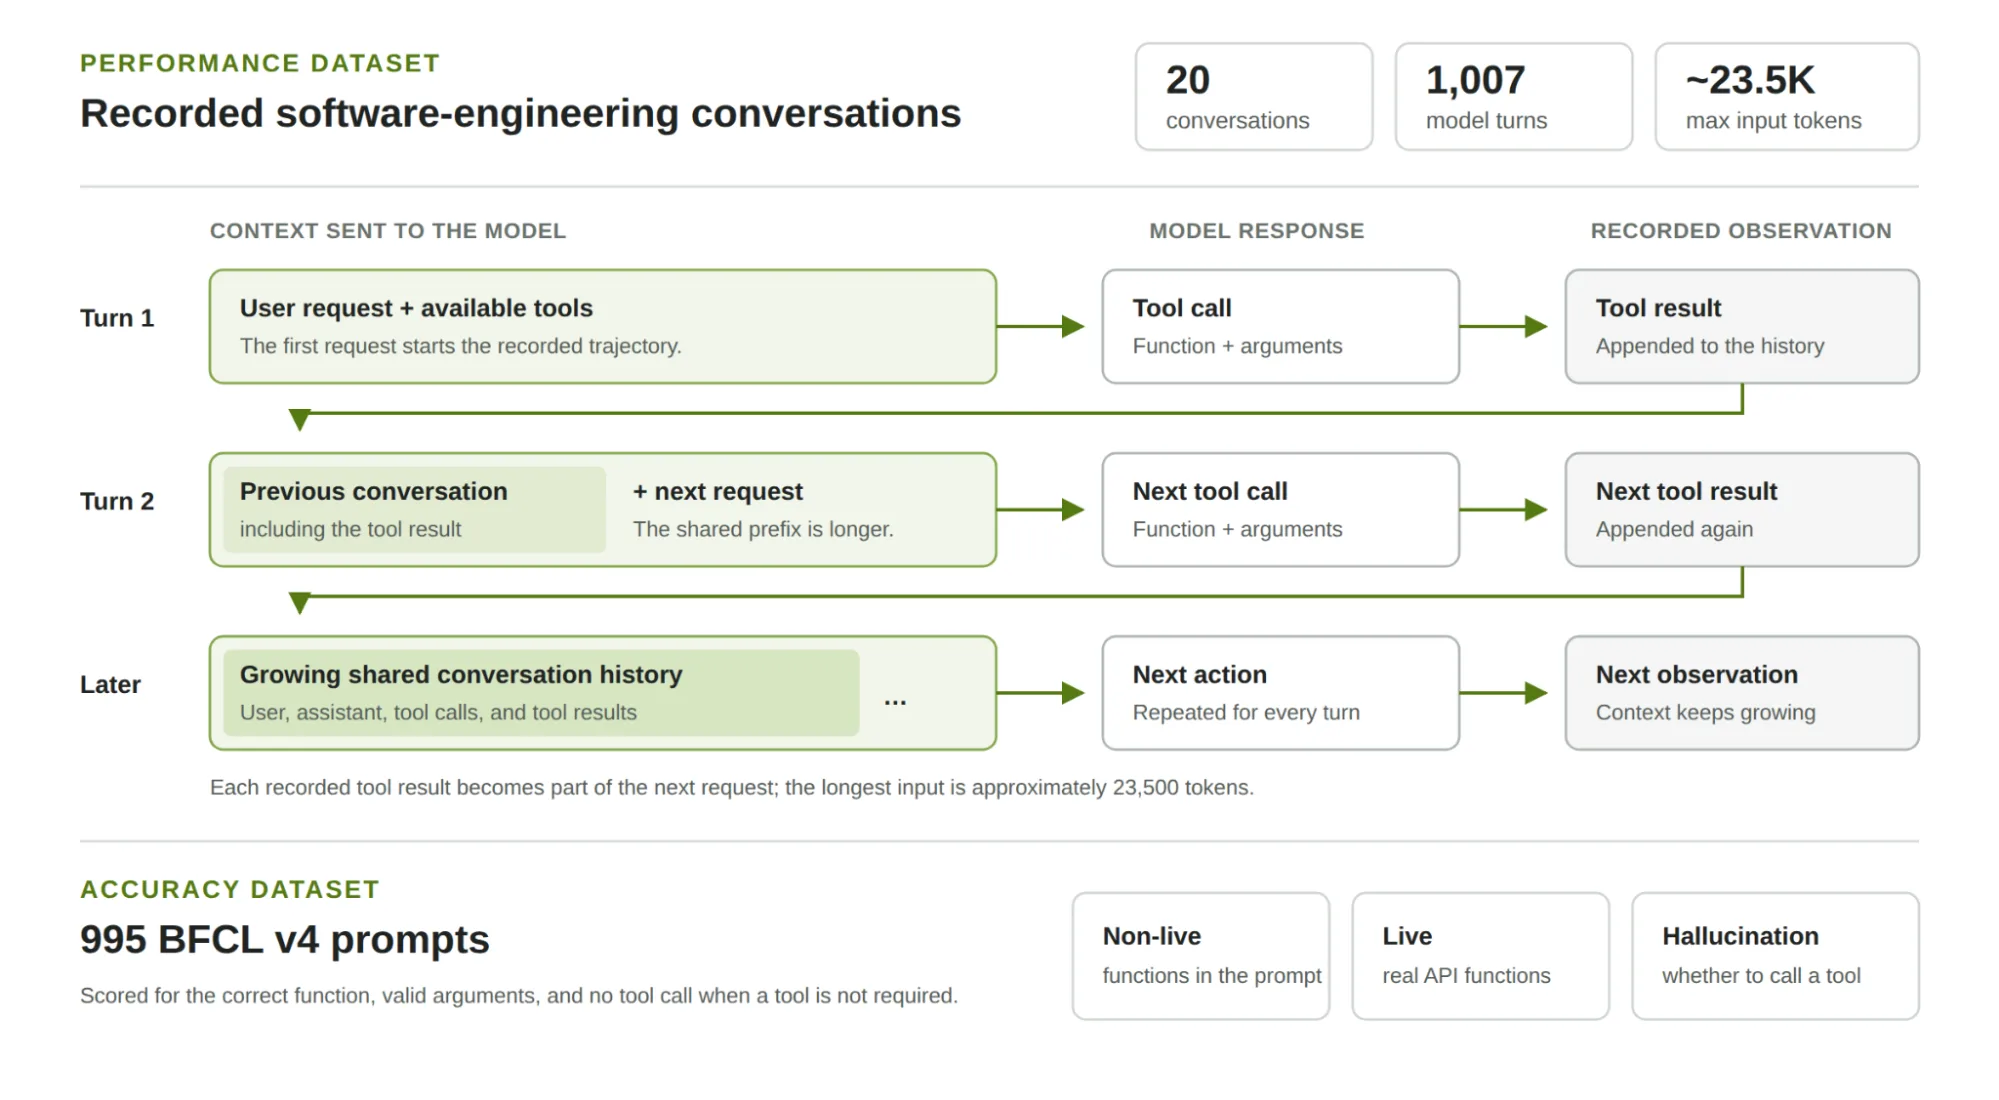
MLPerf Edge Agentic testuje koncový bod kompatibilní s rozhraním OpenAI, tedy službu, na kterou se aplikace obrací stejně jako na běžné cloudové modely. Měří se tedy model vystavený jako služba, nikoli izolovaná matematická operace. Měření má dvě fáze: výkonovou a přesnostní. Ve výkonové fázi se přehrávají zaznamenané trajektorie softwarově inženýrského agenta. Model dostane požadavek uživatele, vygeneruje volání nástroje, prohlédne si jeho výsledek a pokračuje ve stejné konverzaci. Výsledky nástrojů se tak v průběhu práce přidávají do konverzace dřív, než přijde další požadavek na model. Zátěž obsahuje 20 konverzací a 1 007 vygenerovaných kroků, tedy v průměru zhruba padesát kroků na konverzaci. Vstup se s každým krokem prodlužuje, až dosáhne zhruba 23,5 tisíce tokenů. Token je přitom kousek textu, se kterým jazykový model pracuje. Dlouhý kontext je tedy podstatnou součástí zkoušky, nejen vedlejším efektem: model musí opakovaně zpracovávat stále delší historii práce.
Dvě fáze, dva typy dat
Přesnostní fáze používá prompty z Berkeley Function Calling Leaderboard (BFCL) v4, a to jen jednokolové a s vypnutým uvažováním. Podle popisu zkoumá, zda model vybere správnou funkci, vytvoří platné argumenty a nezavolá nástroj, když žádný není potřeba. Dohromady jde o 995 promptů. Obě fáze se proto berou společně: rychlost bez ověření, že model nástroje volá správně, by měla malou vypovídací hodnotu. Zdroj zároveň uvádí, že jednokolový režim s vypnutým uvažováním má vyvážit přesnost a dobu vyhodnocení na okrajových zařízeních. Tento návrh je pro čtenáře důležitý: výsledek 6,4× neznamená jen rychlejší generování textu, ale rychlejší průchod celým cyklem, ve kterém se výsledky nástrojů přidávají do konverzace a model je musí znovu zpracovat. Schéma níže shrnuje, jak jsou obě sady dat v benchmarku rozdělené.
Čísla, která za výsledkem stojí
Přihlášené řešení podle tabulky dosáhlo propustnosti 52,33 tokenu za sekundu. Medián času do prvního tokenu, tedy čekání, než model začne odpovídat, činil 247,12 ms. Medián času na výstupní token, tedy pauza mezi jednotlivými vygenerovanými kousky textu, byl 14,68 ms. Celková přesnost v testu BFCL dosáhla 87,94 %. U interaktivního agenta se hodí sledovat obě časové metriky zvlášť: první říká, jak rychle model po novém požadavku zareaguje, druhá, jak plynule pak pokračuje. Je ale třeba vědět, co zdroj neříká: nesrovnává přesnost s referenčním během llama.cpp a nevysvětluje, jak by se výsledek lišil při jiném nastavení. Referenční běh přitom používal stejný model Qwen3.6-27B s kvantizací Q4_K_M, tedy zhuštěnějším zápisem vah modelu. Jak přesně se obě konfigurace liší dalšími parametry, text v podkladech nerozebírá.
Proč se nevyplatí počítat vše znovu
Podle NVIDIE hrálo klíčovou roli opakované využití dříve vypočtených dat. Agent v každém kroku posílá modelu znovu téměř celou dosavadní konverzaci a přibývá jen malý kousek. Kdyby runtime musel každý prompt zpracovat od začátku, většinu práce by opakoval. Řešení proto znovu používá KV cache a rekurentní stav, tedy uložené výsledky dřívějšího zpracování textu. Na této zátěži se přibližně 96 % tokenů promptu obslouží z horké cache. Runtime pak musí předvyplnit jen asi 0,5 milionu z celkových 13,6 milionu tokenů promptu napříč všemi kroky. Jinými slovy, z každých zhruba dvaceti sedmi tokenů, které by se jinak zpracovávaly znovu, zbývá k předvyplnění jen jeden. Celkový objem promptů je přitom obrovský právě proto, že se v 1 007 krocích stále dokola posílá narůstající historie. Právě v agentních úlohách s narůstajícím kontextem tak může být největší úspora v tom, co se nemusí počítat podruhé.
Stromové ověřování pro volání funkcí
Druhým zdrojem zrychlení je podle NVIDIE stromová predikce. Místo jedné lineární řady návrhů pokračování sleduje runtime více větví a ověřuje je. Autoři to zdůvodňují tím, že při volání funkcí je velká část výstupu předvídatelná: názvy nástrojů, syntaxe JSON i běžné struktury argumentů se často opakují. Takové úseky lze navrhnout dopředu a ověřit je najednou. Zároveň mohou další větve uchovat pravděpodobné alternativy pro konkrétní hodnoty argumentů, takže jedna chybná dílčí hádanka nemusí zmařit celý návrh. Oproti lineární variantě se třemi kroky návrhu měla stromová verze na této zátěži přinést další zhruba 40% nárůst výkonu dekódování. Jde o údaj výrobce platný pro konkrétní test. Zdroj neukazuje, zda by se přínos zachoval u jiných agentních úloh nebo u textu s méně předvídatelnou strukturou. Výhoda se navíc opírá o předvídatelnost strukturovaného výstupu, takže u volnějšího textu bych ji nepředpokládal.
Úzký scénář, ne obecný verdikt
Měření proběhlo v režimu SingleStream na jednom Jetson AGX Thor Developer Kit se 128 GB sjednocené paměti a v režimu napájení MAXN. Dodaná konfigurace nastavuje teplotu 0, seed 42, vypnuté uvažování a souběžnost 1. Zpracovává se tedy jeden požadavek po druhém, bez více uživatelů současně a bez náhodnosti, která by v běžném provozu mohla ovlivnit odpovědi. Výsledek proto platí pro tento přesně vymezený scénář. Podle autorů lze benchmark zopakovat: stačí naklonovat nástroj MLCommons, vytvořit virtuální prostředí, doinstalovat závislosti BFCL, upravit cesty k modelu a tokenizéru v konfiguračním souboru a spustit měření. Stejná konfigurace spouští výkonovou i přesnostní fázi. To je užitečné pro kontrolu, ale samo o sobě to neověřuje nezávislé opakování.
Co zůstává nezodpovězeno
Zdroj dobře popisuje, co se měřilo a jaké hodnoty vyšly, ale na řadu praktických otázek neodpovídá. Nevíme, jak se řešení zachová při souběžných požadavcích, v jiných režimech napájení, na jiném hardwaru nebo s jinými modely. Nevíme ani, jak velkou část zrychlení přinesla cache a jak velkou stromová predikce, protože uvedený 40% přínos se vztahuje jen k porovnání stromové a lineární varianty. Nezodpovězená zůstává i otázka, zda se rozdíl proti llama.cpp projeví mimo benchmark. Nejpevnějším zjištěním je proto úzké, ale konkrétní srovnání: jedna sada, jeden přesně popsaný úkol, 24 minut a 36 sekund proti 2 hodinám a 37 minutám. Pro čtenáře, který zvažuje nasazení agentů na okrajových zařízeních, je užitečné hlavně poučení o tom, kde se čas ztrácí: u dlouhých konverzací s nástroji nerozhoduje jen rychlost samotného generování, ale i to, kolik práce se dá ušetřit opakovaným využitím už zpracovaného kontextu.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- TensorRT Edge-LLM Completes the MLPerf Edge Agentic Benchmark 6.4x Faster on Jetson AGX Thor | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.