
Model pro rutinní kroky agentů
Většina práce AI agentů není hluboké přemýšlení. Jsou to desítky drobných kroků: vybrat nástroj, sestavit argumenty, zkontrolovat výsledek, upravit soubor nebo rozhodnout, co dál. Právě na tuto prováděcí vrstvu míří NVIDIA modelem Nemotron 3.5 Lightning. Podle popisu na blogu OpenRouter jde o model typu směs expertů (mixture-of-experts) s 30 miliardami parametrů. Pro každý zpracovaný token je ale aktivních jen zhruba 3 miliardy.
Architektura je hybridní. Karta modelu podle OpenRouter popisuje střídání vrstev Mamba-2 a vrstev směsi expertů, doplněných vybranými vrstvami pozornosti. Model podporuje konfigurovatelné uvažování a nabízí predikci více tokenů a dva návrhové modely pro spekulativní dekódování, DSpark a DFlash. Ty mají generování zrychlit. K tomu NVIDIA dodává kontrolní bod NVFP4 vyladěný pro inferenci. Číslo 3 miliardy ale nelze číst jako úplný údaj o nárocích: celý model je třeba uložit a sdílené vrstvy se při inferenci také spouštějí.
Vedle většího bratra Ultra
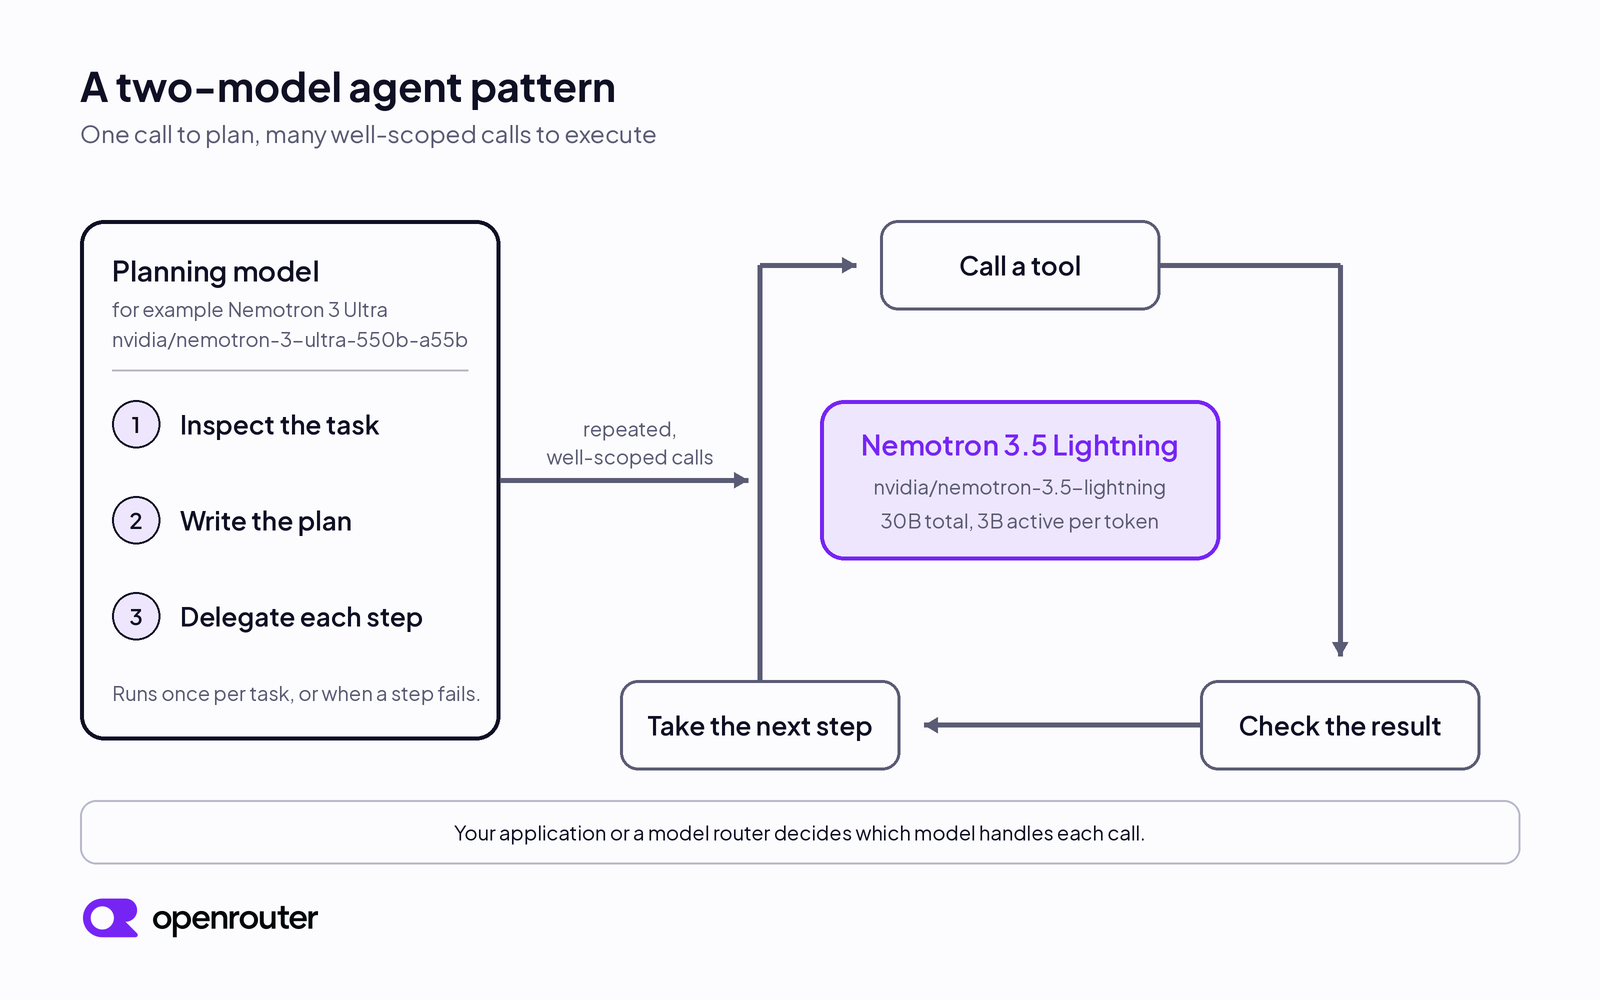
Lightning vznikl destilací z většího modelu Nemotron 3 Ultra, ale podle OpenRouter nejde o zaměnitelné modely. Lightning je menší a určený pro velkoobjemové provádění kroků. Ultra je větší a míří na složité uvažování a orchestraci. Diagram ze zdroje ukazuje dvoumodelový vzor: plánovací model rozebere úlohu a rozdělí kroky, zatímco Lightning v cyklu volá nástroj, kontroluje výsledek a pokračuje. O tom, který model dostane které volání, rozhoduje aplikace nebo směrovač.
Rozdíl je znát na ceníku. Podle srovnání OpenRouter z 11. září 2026 stojí Lightning u poskytovatelů 0,065 až 0,10 USD za milion vstupních tokenů a 0,18 až 0,25 USD za milion výstupních. U Ultra je to 0,50 až 0,625 USD, respektive 2,20 až 3,125 USD. NVIDIA uvádí až čtyřnásobnou propustnost oproti podobně velkým otevřeným modelům. V testu PinchBench prý model dokončil 10 000 úloh agenta až o 30 % rychleji při srovnatelné přesnosti. OpenRouter výslovně dodává, že jde o výsledky výrobce.
Kontext, endpointy a omezení
Na úrovni modelu podporuje Lightning kontext až 1 milion tokenů. Standardní endpointy na OpenRouter ale k 11. září 2026 nabízejí u všech poskytovatelů jen 262 144 tokenů a limity výstupu se pohybují od 32 768 do 235 929 tokenů. Plný milion nabízí bezplatný endpoint se stropem výstupu 65 536 tokenů. Ten však nelistuje response_format ani strukturované výstupy. NVIDIA u něj uvádí, že používání se zaznamenává, a žádá, aby se neposílaly důvěrné ani osobní údaje.
Další past je rozdílná podpora funkcí. Standardní model nvidia/nemotron-3.5-lightning mezi podporovanými parametry uvádí nástroje, tool_choice, response_format i strukturované výstupy. Podpora se ale liší podle poskytovatele, i když jde o stejný model. Pokud na některém parametru závisí funkčnost aplikace, doporučuje OpenRouter nastavit require_parameters na true. Požadavek pak půjde jen k poskytovatelům, kteří podporují všechno, co v něm je. Připojený graf ze zdroje se týká zpracování schémat volání nástrojů v agentních frameworcích.
Lokální provoz a směrování
NVIDIA zveřejňuje referenční váhy BF16 pod licencí OpenMDW-1.1. K nim přidává optimalizovanou verzi NVFP4, kterou doporučuje pro přímou inferenci, a kontrolní bod GGUF pro podporované lokální systémy. OpenRouter proto model nejpřesněji označuje za model s otevřenými váhami (open-weight). Lokální běh ovšem neznamená, že každý stroj zvládne plný milion tokenů. Podle pokynů NVIDIA pro Ollamu se výchozí kontext řídí pamětí VRAM: 4K pod 24 GB, 32K od 24 do 48 GB a 256K od 48 GB.
Nejkonkrétnější údaj o praktickém přínosu pochází z vyhodnocení LangChainu na 145 vícekrokových úlohách agenta. Směrování mezi Lightning a modelem Claude Opus 4.8 tam snížilo náklady o 74 % oproti variantě jen s frontier modelem. Na frontier model přitom putovalo asi 7 % volání. Cenou byla přesnost nižší zhruba o šest bodů. Připojený obrázek ze zdroje srovnává orchestraci v LangChainu a CrewAI s nativním směrováním v OpenRouter.
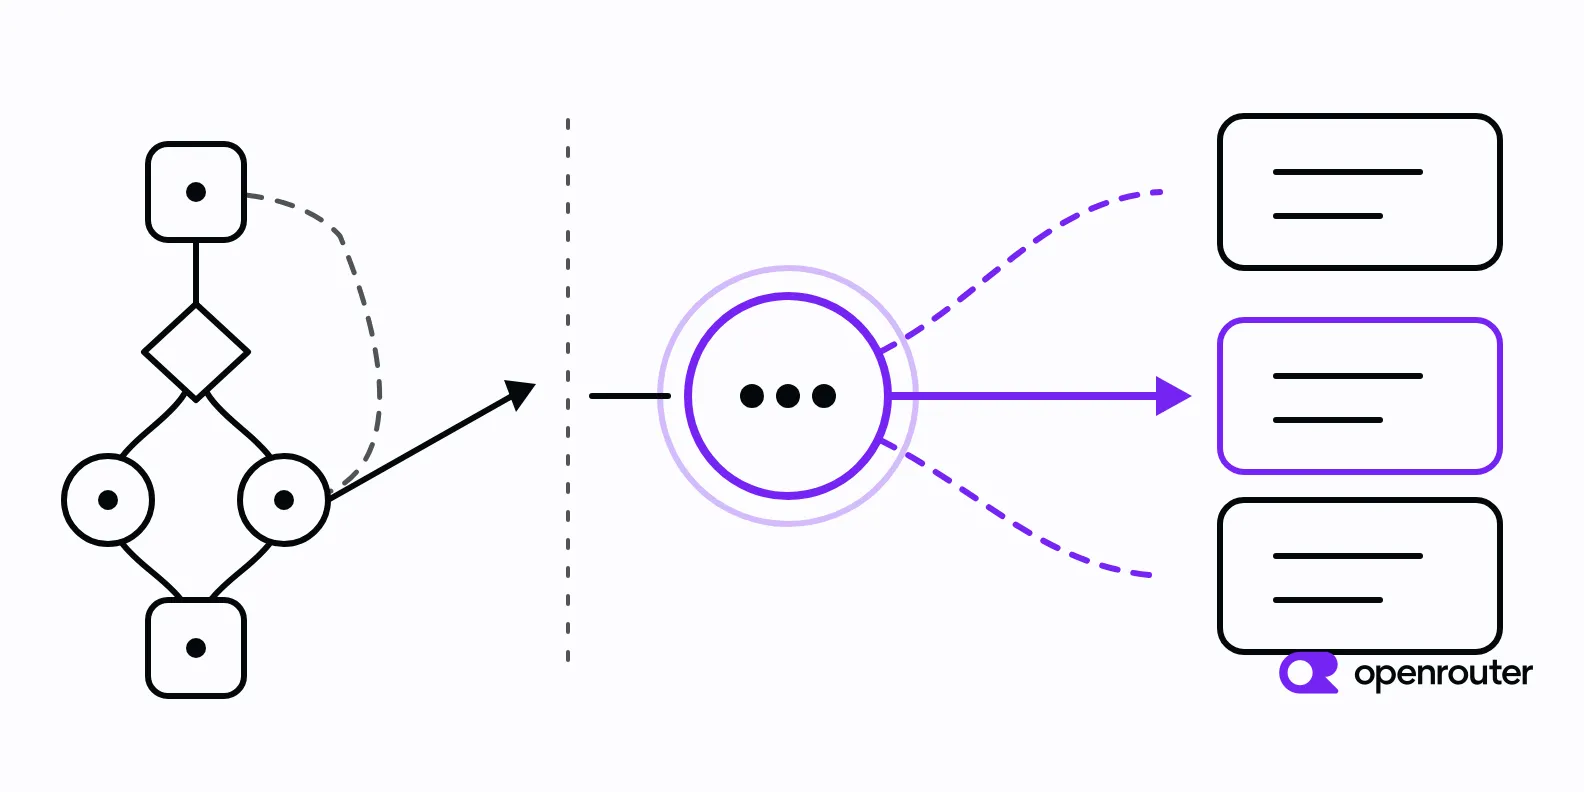
Co zdroj nestanoví? Rychlostní výsledky a čtyřnásobná propustnost pocházejí od NVIDIA a OpenRouter je sám vyzývá ověřit na vlastní zátěži. Údaj o aktivních parametrech neříká nic o celkové paměti. Úspora z testu LangChainu navíc šla ruku v ruce s poklesem přesnosti o šest bodů. Před nasazením tedy dává smysl měřit hlavně náklady na dokončenou úlohu a spolehlivost, a to na vlastních datech i u konkrétního poskytovatele.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- What Is Nemotron 3.5 Lightning? Specs, Context, and API — OpenRouter Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.