
NVIDIA představila Do Inference Now (DIN) Deploy, otevřenou sadu praktických vzorků v jazyce C++. Podle technického blogu společnosti mají vzorky pomoci vývojářům s cestou od checkpointu modelu, tedy uloženého stavu natrénovaného modelu, k nativní aplikaci s hardwarovou akcelerací. Cílovými platformami jsou Windows i Linux. Popis pochází od samotného dodavatele a vypovídá o záměru projektu. Nejde o nezávisle ověřený výsledek a text se proto drží toho, co zdroj výslovně uvádí.
Sada spojuje dvě komponenty: ONNX Runtime a poskytovatele exekuce NVIDIA TensorRT RTX. Podle NVIDIA má kombinace obou částí vývojářům pomoci dostat se od checkpointu modelu k nativní, hardwarově akcelerované aplikaci na Windows a Linuxu. Zdroj v citovaných pasážích neuvádí žádné srovnání s jinými řešeními ani údaje o náročnosti vývoje. Přínos sady tedy zůstává na úrovni deklarovaného účelu.
Od exportu modelu ke C++ aplikaci
Každý vzorek podle NVIDIA začíná exportérem napsaným v Pythonu. Ten stáhne checkpoint modelu z platformy Hugging Face a převede ho na artefakt ve formátu ONNX. Tento artefakt je výstupem exportní části vzorku a dále s ním pracuje aplikační část postavená nad ONNX Runtime.
Druhou částí je aplikace, kterou zdroj popisuje jako nativní C++ CLI, tedy program ovládaný z příkazové řádky, postavený nad ONNX Runtime (ORT). NVIDIA zdůrazňuje, že toto rozdělení drží převod modelu odděleně od logiky nasazení. Vývojáři podle ní mohou exportovaný model převzít do lokální aplikace, aniž by potřebovali běhové prostředí určené pro konkrétní model. Zdroj ale neuvádí žádná měření ani srovnání s jinými postupy. Jde proto o popis zamýšleného uspořádání, nikoli o prokázanou úsporu práce.
Sdílený kód a volitelné akcelerace
Většina vzorového kódu podle NVIDIA využívá rozhraní session a tensor z ONNX Runtime v jazyce C++. Session zde zastupuje načtený model připravený ke spuštění a tensor datovou strukturu, kterou model přijímá a vrací. Tato společná vrstva tvoří jádro vzorků. Kód závislý na konkrétním výrobci, včetně rozhraní CUDA a jejich kernelů, se objevuje jen ve volitelných akcelerovaných cestách. Základ aplikace tak není pevně svázán s jedním dodavatelem hardwaru a specializovaný kód zůstává odděleně tam, kde se akcelerace skutečně využívá.
Z tohoto uspořádání plyne i možnost sdílený kód využít jinde. NVIDIA uvádí, že jej mohou spouštět i další execution providery, pokud podporují potřebná tensor API z ONNX Runtime. Rozhodující je tedy podpora těchto rozhraní, nikoli konkrétní výrobce. Zdroj v citovaných pasážích nejmenuje žádné další providery a neuvádí ani srovnání jejich výkonu. Tvrzení je proto třeba chápat jako deklarovanou vlastnost návrhu vzorků. Jak dobře funguje v praxi, ukáže až samostatné vyzkoušení.
Měření na DGX Spark
Nejkonkrétnější čísla přináší tabulka měření na zařízení DGX Spark, která v blogu srovnává běh vybraných úloh na GPU a na CPU. U zvukových modelů jsou výsledky uvedeny jako násobky reálného času a vyšší číslo znamená rychlejší zpracování. Model Parakeet TDT dosáhl na GPU 206,41násobku reálného času, na CPU 14,44násobku. Whisper large-v3-turbo dosáhl 58,5násobku na GPU oproti 3,8násobku na CPU a Nemotron ASR Streaming 39,01násobku oproti 3,24násobku. Tabulka uvádí také model SAM 2.1, který běžel rychlostí 38,3 FPS na GPU a 0,5 FPS na CPU.
U modelu Whisper large-v3-turbo vychází 58,5násobek na GPU proti 3,8násobku na CPU, což je podle přepočtu rozdíl zhruba patnáctinásobný. Nemotron ASR Streaming zpracovává zvuk na GPU 39,01krát rychleji než v reálném čase, na CPU 3,24krát, tedy přibližně dvanáctkrát rychleji na GPU. Tabulka obsahuje také model SAM 2.1 Hiera Base Plus, jehož výkon se udává v snímcích za sekundu: 38,3 FPS na GPU a 0,5 FPS na CPU. Všechna čísla pocházejí z blogu NVIDIA, tedy od dodavatele platformy. Zdroj k nim v citovaných pasážích nepřidává podrobnosti o způsobu měření ani vysvětlení příčin rozdílů, takže je text nedoplňuje. Ukazují jen to, že v testovaných případech byla GPU na tomto zařízení výrazně rychlejší než CPU.
Kvantizace bez zásahu do aplikace
Další ukázka se týká kvantizace, tedy úpravy modelu, která se v tomto případě provádí až po tréninku. Vzorek FLUX.2 slouží ke generování obrázků podle textového zadání a předvádí takzvanou post-training kvantizaci (PTQ) pomocí nástroje NVIDIA Model Optimizer. Výsledkem je kvantizovaný model ve formátu ONNX. Podle autorů blogu ho lze použít místo původního modelu a v aplikačním kódu není nutné nic měnit. Důvodem je, že rozhraní ONNX zůstávají beze změny.
Autoři zároveň upozorňují, že kvantizace závisí na konkrétním hardwaru. Podle nich ale zůstávají rozhraní ONNX beze změny, takže kvantizovaný model lze vyměnit za původní bez úprav aplikačního kódu. Tvrzení pochází od dodavatele platformy a vztahuje se na popsaný vzorek. Zdroj v citovaných pasážích nerozebírá dopady na kvalitu výstupů ani na jiné modely.
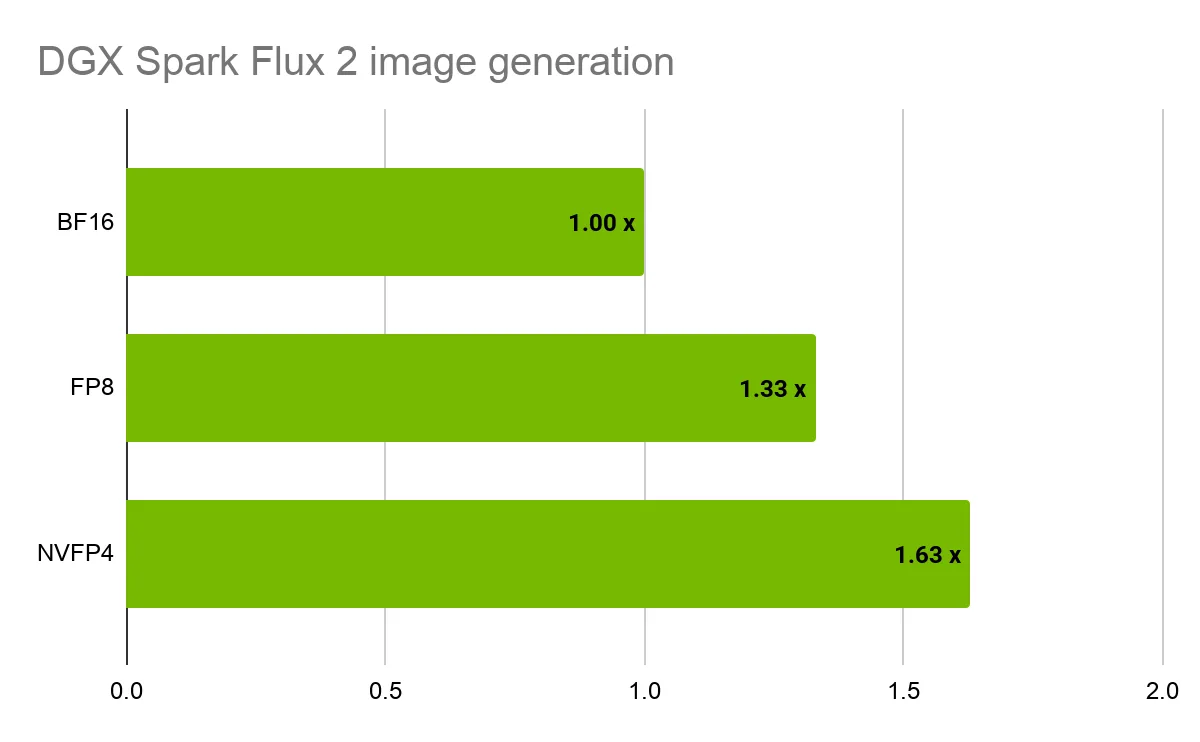
K tomuto vzorku patří graf, který porovnává model FLUX.2-klein-4B podle použité číselné přesnosti. Referenčním výsledkem je verze BF16. Při přesnosti FP8 model dosahuje 1,33násobku tohoto výsledku, při NVFP4 pak 1,63násobku. Z grafu tak vyplývá, že nižší přesnost v tomto měření přinesla vyšší hodnotu, přičemž NVFP4 je v ukázce nejvýraznější. Čísla pocházejí z materiálů NVIDIA a dostupné pasáže neuvádějí, jakou veličinu přesně vyjadřují ani jak byla měřena, proto je dále nevykládáme.
Co z toho plyne
DIN Deploy je podle dostupných podkladů především sbírka vzorků, která ukazuje ucelený postup: export modelu v Pythonu, nativní C++ aplikaci nad ONNX Runtime a volitelné akcelerované cesty pro TensorRT RTX. Silnou stránkou je oddělení převodu modelu od logiky nasazení i omezení kódu závislého na výrobci na volitelné části. Měření na DGX Spark a graf kvantizace ukazují potenciál akcelerace. Všechna čísla ale pocházejí od NVIDIA a zdroj k nim neuvádí širší srovnání. Posoudit, jak se sada osvědčí na jiném hardwaru nebo s jinými modely, půjde až po samostatném vyzkoušení.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Build Local AI Apps with C++ and NVIDIA TensorRT RTX Samples | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.