
Byl představen nový benchmark SWE-Serve, který hodnotí inženýrské úlohy při provozu systémů pro umělou inteligenci. Vznikl s podílem týmu SGLang, což je open-source systém určený pro provoz velkých jazykových modelů (LLM). Benchmark testuje úlohy odvozené z reálných sloučených změn projektu SGLang.
Pro svou tvorbu využil SWE-Serve 83 sloučených pull requestů z projektu SGLang, které následně převedl na 53 spustitelných úloh. Tyto úkoly jsou rozděleny do šesti oblastí inferenčního inženýrství, mezi které patří například plánování, cachování, dekódování nebo serving API.
Metodika testování agentů
Metodika testování agentů začíná tak, že AI agent obdrží instrukci k vyřešení úkolu. K dispozici dostává kontejnerizovanou kopii systému SGLang ve stavu před provedením cílové změny. Patch uspěje pouze tehdy, pokud splní skrytý verifikátor dané úlohy na deklarovaném hardwaru. Agentovo řešení se přitom nesrovnává s referenčním řešením.
K posuzení úspěšnosti vypracovaného patchu není využíváno srovnávání s referenčním řešením. Namísto toho je výsledek ověřován pomocí skrytého verifikátoru dané úlohy, který musí být úspěšně splněn na deklarovaném hardwaru. Patch je tedy považován za úspěšný pouze v případě, že projde touto interní kontrolou, což zajišťuje, že změna v kódu skutečně funguje v požadovaném prostředí a splňuje technické specifikace úkolu. Využití skrytého verifikátoru namísto srovnávání s referenčním řešením je zásadní metodickou volbou. Referenční řešení by mohlo modely navést k pouhé imitaci stylu původního autora, zatímco verifikátor hodnotí pouze funkční správnost výsledku. To znamená, že pokud agent najde alternativní, efektivnější způsob, jak vyřešit problém, bude patch uznán za úspěšný, i když se liší od původního pull requestu. Podmínka spuštění na deklarovaném hardwaru navíc zajišťuje, že jsou brány v úvahu i hardwarové omezení a specifika GPU akcelerace, která jsou pro serving LLM nezbytná.
Výsledky a efektivita modelů
Výsledky testování jedenácti různých modelů ukazují značnou variabilitu v jejich schopnosti úspěšně vyřešit zadané úkoly. Při použití nejlepších konfigurací pro každý z modelů se průměrná úspěšnost při prvním pokusu, označovaná jako pass@1, pohybuje v rozmezí od 34,6 % do 75,5 %. Tato data odrážejí rozdílnou efektivitu jednotlivých systémů při aplikaci oprav do kódové základny v simulovaném prostředí. Tato variabilita naznačuje, že zatímco některé modely již disponují pokročilými schopnostmi pro úpravu specializovaného systémového kódu, jiné stále vykazují značné nedostatky v logice implementace.
Nejvyšší úspěšnost dosáhly modely Claude Opus 5 a GPT-5.6 Sol, které obě zaznamenaly průměrnou hodnotu pass@1 kolem 75 %. Další skupina modelů, mezi nimiž jsou Claude Sonnet 5x, Kimi K3, GPT-5.6 Luna a GPT-5.6 Terra, podala obdobný výkon s průměrem 64 %. Nižší efektivitu vykazovaly ostatní testované systémy, přičemž nejnižší průměrnou úspěšnost s hodnotou 35 % zaznamenal model Inkling Sx.
Kritická role testů živého servování
Význam testů živého servování ukazují data u 19 úloh, které spouštějí živý server. Úplným verifikátorem v nich prošlo pouze 45,9 % patchů od agentů. Pokud byly kontroly živého servování vynechány, úspěšnost stoupla na 69,4 %. Zhruba každý třetí patch, který prošel ostatními kontrolami, tedy v testech živého servování selhal. Tyto údaje se vztahují jen na zmíněných 19 úloh. Tento propad v úspěšnosti zdůrazňuje, že statické analýzy a základní testy často nestačí k odhalení chyb, které se projeví až při skutečném provozu serveru pod zátěží.
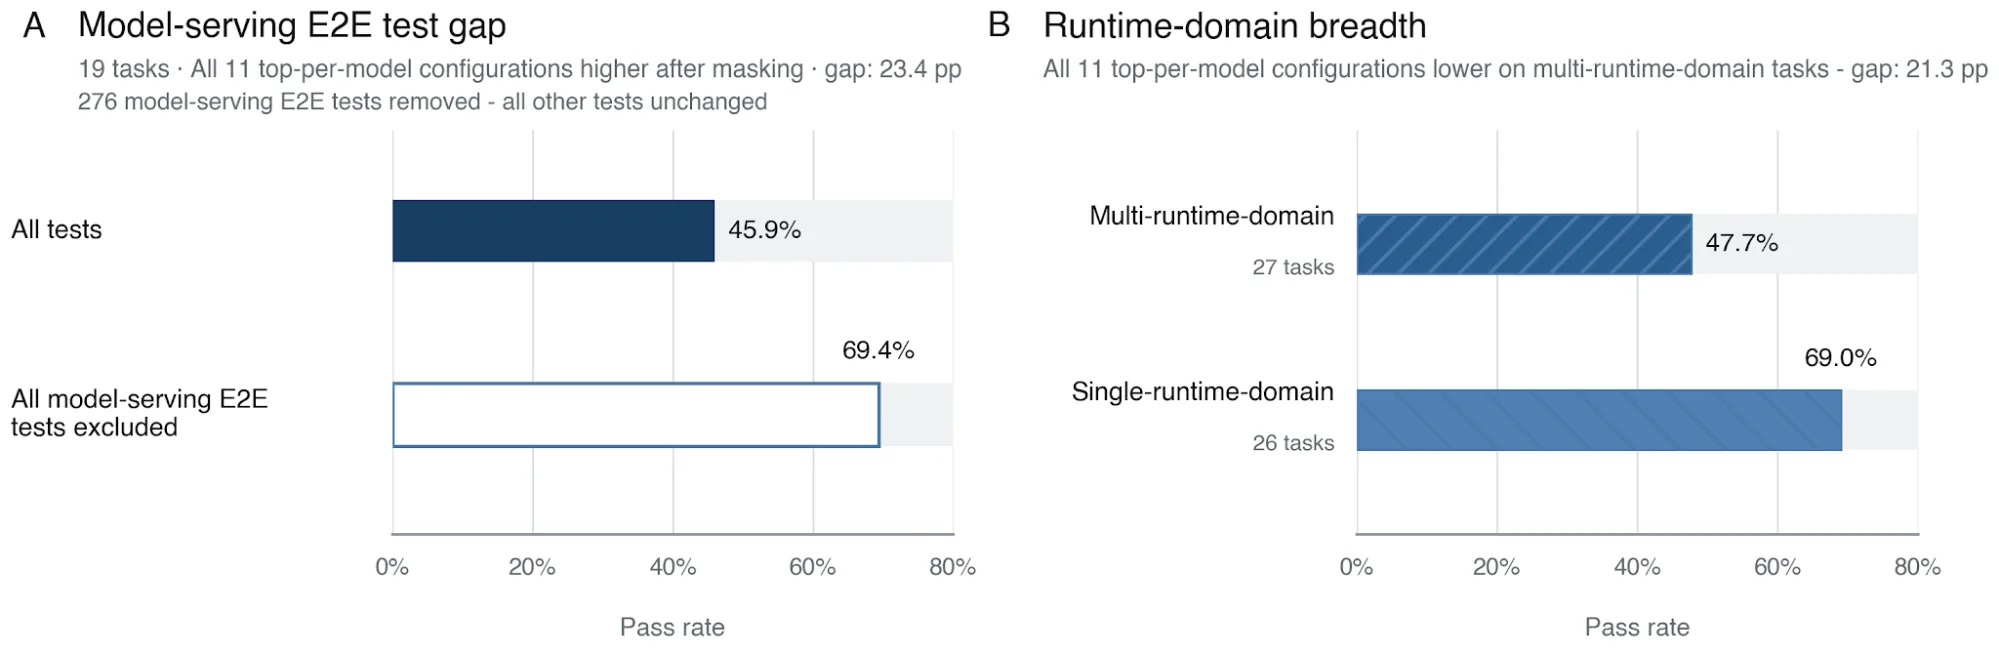
Složitost úloh ovlivňuje i výsledky testovaných modelů. Úlohy, které zasahují do více runtime domén, jako je zpracování požadavků, plánování, spuštění modelu nebo správa KV cache, mají úspěšnost 47,7 %. Úlohy omezené na jedinou doménu dosahují úspěšnosti 69,0 %. Rozdíl činí 21,3 procentního bodu a stejným směrem ho ukazuje každé testované nastavení modelu.
Interpretace výsledků a omezení
Interpretace výsledků a omezení benchmarku SWE-Serve vyžadují opatrnost, protože úspěšné dokončení úkolu má v tomto kontextu velmi úzký význam. Dosahování pozitivních výsledků v tomto testovacím prostředí znamená pouze to, že navržená oprava v podobě patchu splnila specifické požadavky verifikátoru benchmarku. Tento automatizovaný proces potvrzuje technickou shodu s definovanými kritérii, ale není možné jej zaměňovat za komplexní validaci kvality kódu, která by probíhala v reálném vývojovém cyklu softwaru.
Je důležité zdůraznit, že testy v rámci SWE-Serve nenahrazují standardní proces kontroly a revize, který probíhá u projektu SGLang. Úspěch v benchmarku tedy neznamená, že je patch připraven k okamžitému sloučení do hlavního větve kódu, nebo že je plně nasaditelný do produkčního prostředí. Výsledky rovněž neznamenají automatické schválení ze strany správců projektu SGLang, jelikož automatizované testy nemohou plně zastoupit lidský kontrolní proces a jeho přísná kritéria pro přijetí změn. Tento rozdíl je dán tím, že automatizovaný verifikátor kontroluje pouze konkrétní výstupní metriky nebo funkční stavy, zatímco lidský review proces v SGLang zkoumá i aspekty jako udržitelnost kódu, dodržení stylistických konvencí, potenciální dopady na dlouhodobou stabilitu a bezpečnost. Patch může tedy projít benchmarkem, protože 'funguje', ale být zamítnut správcem projektu, protože je napsán neefektivně nebo narušuje architekturu systému. SWE-Serve tak slouží jako indikátor technického potenciálu agentů, nikoliv jako plná náhrada za kvalifikovaného softwarového inženýra.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- How SWE-Serve Exposes the Gap Between Local Tests and Live Serving | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.