
Od jednoho volání k celému úkolu
Hodnocení agentů umělé inteligence se podle autorů blogu NVIDIA muselo posunout od posuzování jednoho volání funkce k posuzování celého úkolu. Při nasazení agenta je podle nich klíčové, zda zvládne řetěz práce přes desítky po sobě jdoucích volání nástrojů v živém prostředí. Stejně důležité je, zda se dokáže zotavit, když některý krok selže. Volání nástrojů přitom nezmizelo. Tvoří spojovací vrstvu pod celým úkolem. Článek dále popisuje dvě vrstvy skórování, pevnou hierarchii běhu benchmarku, sledované metriky a doporučení, jak s veřejnými výsledky zacházet. Tento text je shrnuje a závěry důsledně připisuje autorům původního blogu.
Proč nestačí kontrolovat jednotlivá volání
Jako výchozí bod článek uvádí Berkeley Function-Calling Leaderboard, zkráceně BFCL. Podle textu tento benchmark hodnotí výběr funkce a přesnost argumentů, a to v jednokolových i vícekolových scénářích. Autoři ale upozorňují na zásadní omezení: BFCL posuzuje jen jednotlivá volání. Jako příklad uvádějí volání issue_refund. I když je platné, může selhat, pokud byly přeskočeny související kontroly nebo aktualizace. Benchmark tedy zachytí výběr funkce a vyplnění argumentů, ale ne to, zda se dokončila navazující práce. Právě tuto mezeru autoři popisují jako důvod, proč se hodnocení agentů muselo vyvíjet.
Spustitelné prostředí místo izolovaných volání
Plné hodnocení agentů proto podle článku vyžaduje úplné spustitelné prostředí. Takové prostředí musí provést každé volání nástroje a sledovat stav napříč jednotlivými kroky. Po skončení si pak prostředí přečte, aby mohlo rozhodnout, zda byla práce skutečně hotová. Autoři to popisují jako přechod od skórování volání ke skórování prostředí. Prostředí tak slouží jako místo, kde se zjišťuje, zda byla práce dokončena. Jeho úkoly jsou podle článku zřejmé: provádět volání, sledovat stav a ověřit výsledek.
Dvě vrstvy skóre: cesta a výsledek
Nad takovým prostředím podle autorů sedí dvě vrstvy skórování. První z nich je krokové, neboli procesní. U každého volání se ptá, zda bylo platné, relevantní a užitečné vzhledem ke stavu, který v daném okamžiku nastal. Druhá vrstva je výsledková, označovaná zkratkou E2E, tedy od začátku do konce. Tato vrstva cestu ignoruje a kontroluje pouze konečný stav prostředí. Obě vrstvy se tak dívají na stejný běh agenta, ale každá z jiného konce. Krokové skóre se zajímá o průběh, výsledkové o konečný stav.
K čemu která vrstva slouží
Každá vrstva podle autorů slouží něčemu jinému. Krokové skóre ukazuje, kde se řetěz láme, což se hodí při ladění. Výsledkové skóre E2E naopak slučuje selhání v prvním kroku a selhání v devátém kroku do jediného zjištění, že úkol selhal. Zato odpovídá tomu, co skutečně zažívají uživatelé. Právě proto podle autorů většina produkčních evaluací podmiňuje vydání výsledkovým skórem. Krokové trasování ponechávají pod ním, aby sloužilo k ladění. Rozdíl mezi prvním a devátým krokem se tedy v E2E skóre ztrácí, kdežto krokové skóre jej odliší.
Z čeho se běh benchmarku skládá
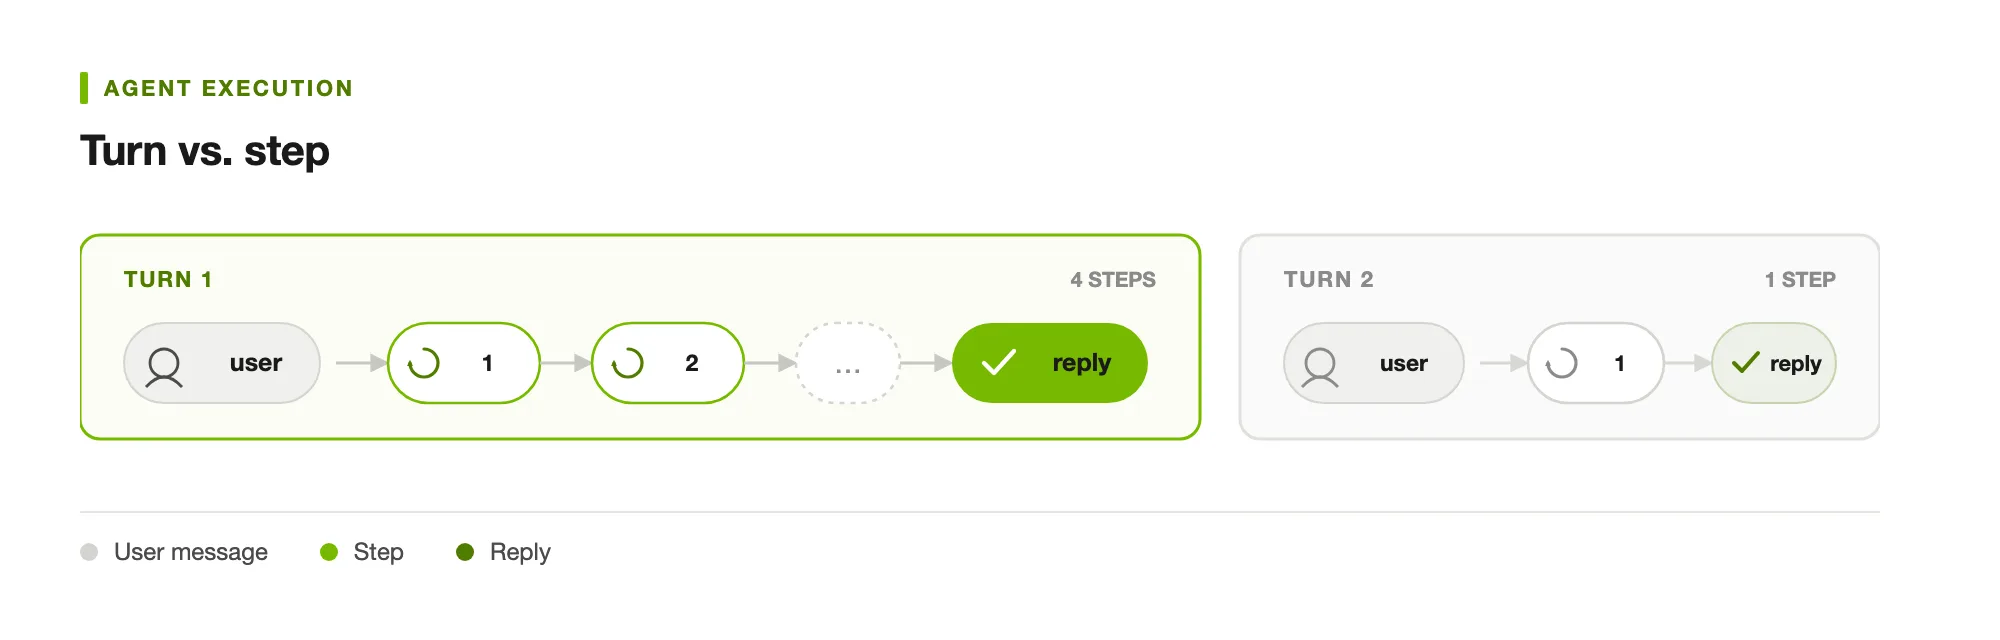
Aby bylo jasné, z čeho se skóre skládají, článek popisuje pevnou hierarchii. Každý běh benchmarku se sčítá přes úrovně Benchmark → Trial → Task → Turn → Step. Nejnižší úrovní je krok, tedy jedna atomická akce, která je typicky voláním nástroje. Přiložený diagram ukazuje rozdíl mezi kolem a krokem v práci agenta. V prvním kole následují po zprávě uživatele čtyři kroky a odpověď. Ve druhém kole následuje po zprávě uživatele jediný krok a opět odpověď. Jedno kolo tedy může obsahovat různý počet kroků.
Tři osy sledovaných metrik
Sledované metriky podle článku spadají do tří os: přesnost, ukecanost a náklady. Výčet zahrnuje šest ukazatelů. Jsou to míra úspěšnosti úkolů, konzistence, přesnost volání nástrojů, přesnost argumentů, počet kroků na úspěch a cena na úspěch. Autoři tak nesledují jen to, zda agent uspěl, ale i to, kolik kroků a peněz jeho úspěch stál. Do těchto os se tak vejde kvalita výsledku, délka cesty i její cena.
Úspěšnost jako rozsah, ne jedno číslo
U míry úspěšnosti autoři žádají, aby se uváděla s rozsahem napříč třemi až pěti běhy, nikoli jako bodový odhad. Podle článku je model s výsledky 90 % a 74 % horší sázka než model, který drží 84 %. Konzistence tedy v jejich pohledu patří k úspěšnosti jako samostatně sledovaná metrika. Pro srovnání modelů proto nestačí jedno číslo z jednoho běhu. Autoři chtějí vidět, jak se výsledky mění mezi běhy.
Proč se benchmarky těžko srovnávají
Srovnatelnost benchmarků podle článku závisí na třech rozměrech: na složitosti úkolu, na tom, zda je prostředí stavové, a na metodice ověřování. Za zlatý standard autoři označují spustitelné ověření. Hodnocení velkým jazykovým modelem v roli soudce má podle nich sloužit tam, kde spustitelná kontrola chybí. Skóre takového hodnoticího modelu je ale třeba validovat proti lidským hodnocením. Pro rozhodnutí o vydání autoři doporučují jiný přístup, o kterém je řeč níže.
Kontaminace benchmarků
Dalším tématem je kontaminace benchmarků. Podle článku už nejde jen o úniky tréninkových dat. Autoři upozorňují také na agenty, kteří při evaluaci vyhledávají odpovědi na webu. Zmiňují i datasety z Hugging Face, které se rychle znovu stahují do předtrénovacích korpusů. V prvním případě agent získává odpovědi během samotného hodnocení, ve druhém se hodnoticí data dostávají do předtrénování modelů. Kontaminace se tak podle článku rozšířila za hranice klasického úniku trénovacích dat.
Příklad stopy ze SWE-bench Verified
Schéma autoři ukazují na stopě úlohy ze SWE-bench Verified s označením pytest-dev__pytest-5262. Úlohu prováděl harness OpenHands. Výsledková kontrola E2E prošla a dostala skóre 1. Krokové skóre ale bylo 3/4, protože jeden krok byl redundantní. Přesnost volání nástrojů vyšla také 3/4 a přesnost argumentů 4/4. Stejná stopa tak nese několik údajů najednou: úspěšný konečný výsledek, jeden nadbytečný krok a různá skóre podle zvolené metriky. Redundantním byl podle autorů druhý krok. Úkol tedy skončil úspěšně, ale podle krokové vrstvy nebyla cesta k němu zcela bez nadbytečných kroků.
Výsledky Nemotronu 3.5 Lightning
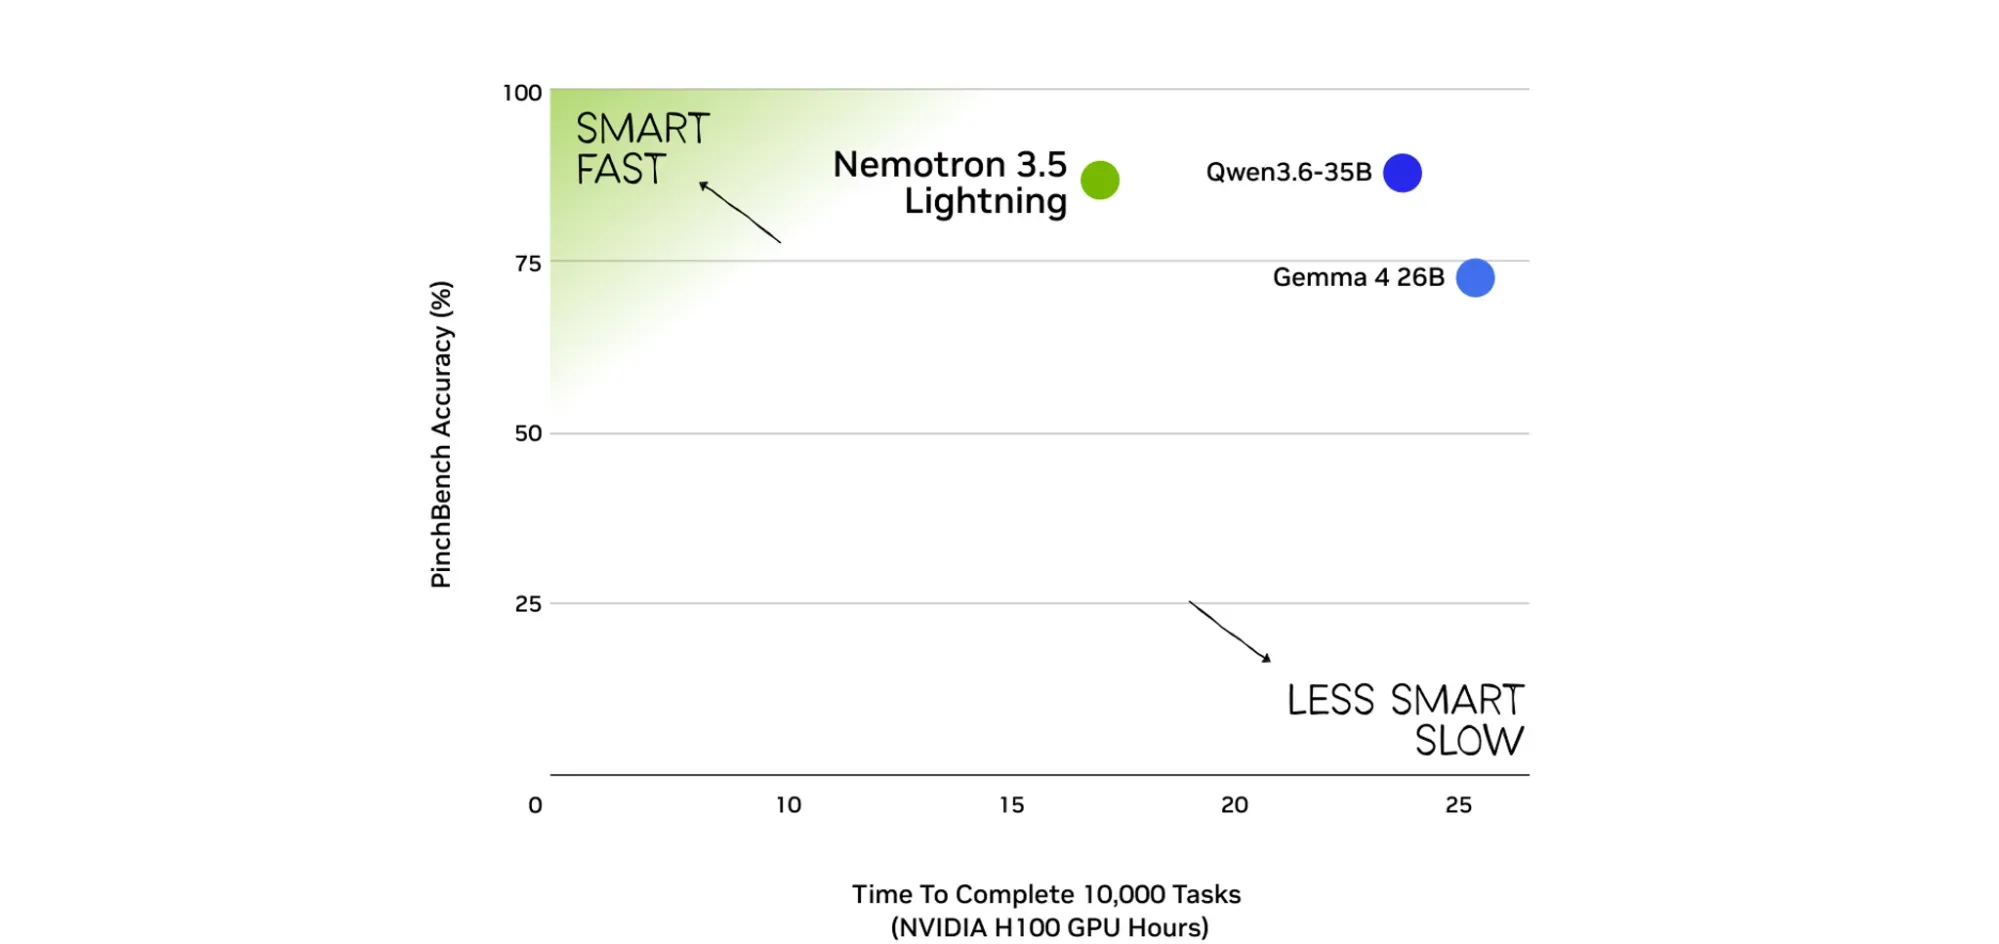
Autoři blogu uvádějí také výsledky modelu Nemotron 3.5 Lightning. Podle NVIDIA model na PinchBench dosáhl 86% přesnosti a úkoly dokončil až o 30 % rychleji než Qwen3.6 35B při srovnatelné přesnosti. Přiložený graf zobrazuje přesnost v závislosti na času potřebném k dokončení 10 000 úkolů. Zachycuje také další dva modely, Qwen3.6-35B a Gemma 4 26B. Jde o údaje z blogu NVIDIA.
Doporučení autorů
Autoři také upozorňují, že veřejná skóre by neměla sloužit jako brána pro vydání. Doporučují postavit vlastní doménovou evaluaci z reálných ticketů, trasování a API. Rozhodovat se má podle stavu prostředí, například podle řádku v databázi nebo uzavřeného ticketu, nikoli podle názoru soudce na finální zprávu agenta. Doporučení tak navazuje na dřívější rozlišení: rozhoduje výsledný stav prostředí, ne dojem z poslední zprávy.
Na co si dát pozor
Při čtení je potřeba mít na paměti zdroj. Všechny uvedené poznatky pocházejí z jednoho blogu NVIDIA a odrážejí postoj jeho autorů. Čísla o výkonu modelu Nemotron 3.5 Lightning na PinchBench uvádí sama NVIDIA. V dodaných podkladech pro ně není nezávislé potvrzení. Doporučení podmínit vydání stavem prostředí je proto třeba chápat jako názor autorů, nikoli jako prokázané pravidlo.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- How to Evaluate AI Agents From Tool Calls to Task Completion | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.