
Co NeMo Relay podle NVIDIA zachycuje
Podle autorů NeMo Relay poskytuje jednotný způsob, jak zaznamenávat podklady pro vyhodnocení změn v agentním harnessu. ATOF uchovává uspořádané události životního cyklu a ATIF zobrazuje stejný běh jako čitelnou trajektorii. Autoři příslušného textu zdůrazňují, že agent může úlohu dokončit a přesto zvolit neefektivní cestu. Text popisuje tři reprezentace jednoho běhu, dva experimenty s agentem Hermes Agent a případovou studii Hermes ToolPerf. V ní podle autorů samotný úspěch či neúspěch úloh nestačil k závěrům, které umožnily až stopy běhů. Níže shrnujeme, co text tvrdí, jak jsou experimenty nastavené a jaká omezení autoři sami uvádějí.
Správný výsledek skrývá zbytečné kroky
Autoři zdůrazňují, že agent může úlohu dokončit a přesto zvolit neefektivní cestu. Uvádějí dva případy. Neúspěšné vyhledávání může spustit další vyhledávání. Zkrácené čtení souboru může vést k příkazu, který znovu načte stejný obsah. Správná finální odpověď tyto kroky skryje. Přitom zvyšují latenci a spotřebu tokenů. Správný výsledek tedy sám tyto přidané kroky neodhalí.
Tři reprezentace jednoho běhu
Tutoriál pracuje s agentem Hermes Agent. Podle textu obsahuje NeMo Relay nativně. Své relace, tahy, volání modelu i volání nástrojů zobrazuje v hierarchii oborů (scope) NeMo Relay. Autoři pracují se třemi reprezentacemi běhu agenta. První z nich, ATOF, je log ve formátu JSONL. Zaznamenává začátky a konce oborů a okamžité značky, které mají identifikátory a časová razítka. ATIF je krokový záznam ve formátu JSON. Popisuje interakce agenta, volání nástrojů a pozorování. Třetí reprezentací je OpenTelemetry s popisky OpenInference.
Požadavek na nástroj není potvrzení
Mezi formáty je podstatný rozdíl. Požadavek na nástroj v ATIF ukazuje, co model chtěl spustit. Výsledek ale nepotvrzuje. Skutečný průběh je proto potřeba ověřit v ATOF. Autoři radí hledat odpovídající události začátku a konce nástroje a také zaznamenané chyby. Záznam požadavku tedy sám neříká, jak akce dopadla.
První experiment: pevný výstup
První experiment spouští v izolovaném kontejneru Docker skript, který vypíše VALUE=42. Tento pevný výstup slouží jako přesná kontrola úspěchu. Kontejner nemá přístup k síti, k repozitáři ani k API klíči NVIDIA. Správnost výsledku se tak posuzuje proti jediné pevné hodnotě. Úspěch se dá posoudit jednoznačně: buď skript vypsal očekávanou hodnotu, nebo ne.
Samostatné prostředí pro ukázku
Setup skript z repozitáře vytvoří samostatné prostředí v adresáři .tutorial-runtime/. Obsahuje Python 3.11, Hermes 0.21.1 a NeMo Relay 0.8.3. Stávající instalaci Pythonu ani Hermes nemění. Ukázka je tak oddělena od stávající instalace.
Co zaznamenal ukázkový běh
V ukázkovém ověřeném běhu zaznamenal ATOF 74 událostí. Dokončeny byly dva obory LLM a oba měly údaje o využití tokenů. Šlo o 7 239 promptových a 96 výstupních tokenů, dohromady tedy 7 335. Log obsahuje jedno volání nástroje a žádnou chybu nástroje. ATIF zobrazil stejný běh jako tři kroky. Ukázka tak ukazuje, jak stejný průběh vypadá v podrobném logu ATOF a v kratším krokovém záznamu ATIF: první eviduje 74 událostí, druhý tři kroky. Autoři dodávají, že počty tokenů a identifikátory se mezi běhy mohou lišit, takže jiný běh nemusí dát přesně stejná čísla.
Druhý experiment: hledání konference
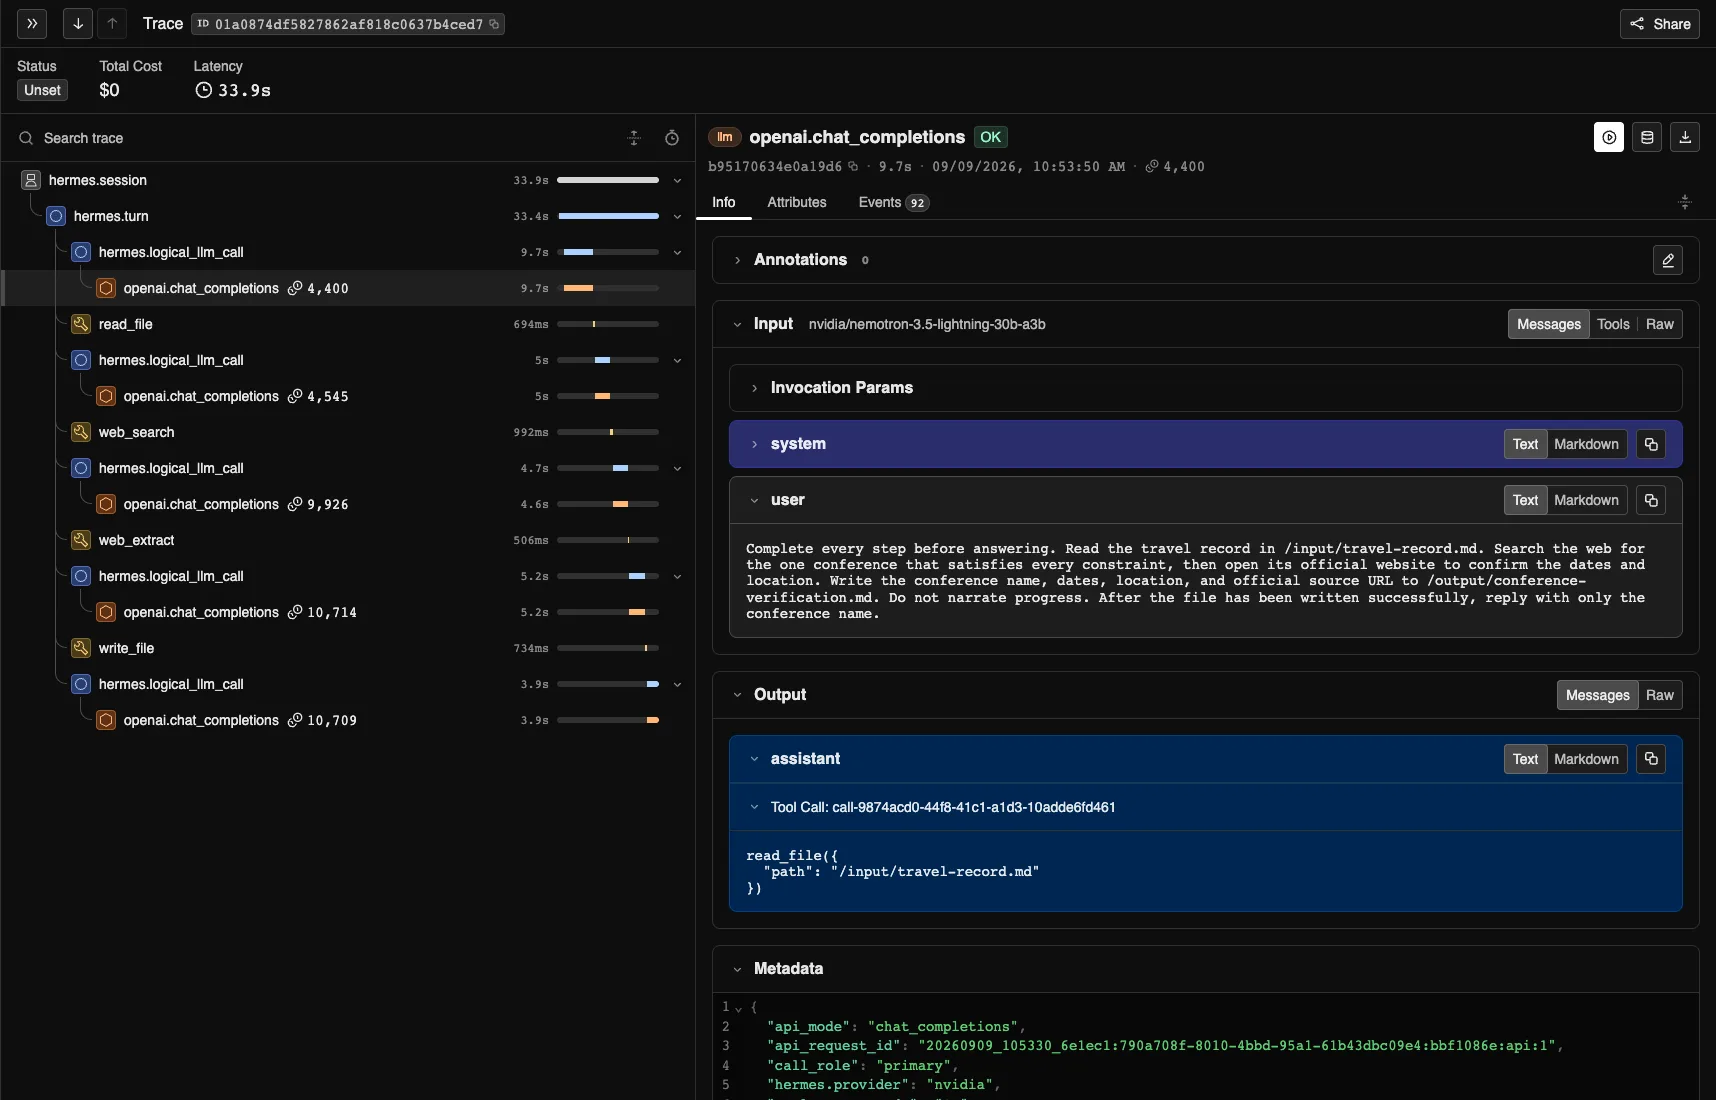
Druhý experiment zadává agentu Hermes úlohu vyhledat konferenci podle cestovního záznamu. Agent musí záznam přečíst a najít konferenci, která odpovídá tématu, datům a místu. Dále ji musí potvrdit na oficiálním webu, uložit report a vrátit název konference.
Trasa ve Phoenixu
Pro zobrazení běhu se používá exportér OpenInference z NeMo Relay. Posílá spany OpenTelemetry přes protokol OTLP do nástroje Arize Phoenix. Phoenix zobrazí běh jako interaktivní trasu. Ta obsahuje volání modelu a nástrojů, časování, využití tokenů a chyby. Podle autorů lze stejnou trasu poslat i do jiných backendů s podporou OTLP, například do LangSmith.
Co kontroluje runner
Před ohlášením úspěchu runner kontroluje několik podmínek. Hermes musí určit COLT 2026 jako název konference. Musí také uložit report. Dále musí úspěšně dokončit volání read_file, web_search, web_extract a write_file. Runner navíc vyžaduje neprázdnou trajektorii ATIF. Ve Phoenixu musí být spany s kladným využitím tokenů. Kontrola tedy zahrnuje nejen uložený report, ale i záznamy o provedených voláních a o využití tokenů.
Omezení druhého experimentu
Autoři sami upozorňují na omezení tohoto experimentu. Úloha používá živé webové vyhledávání. Proto podle nich slouží ke zkoumání chování, nikoli k řazení modelů. Kontrolované srovnání by vyžadovalo pevné odpovědi vyhledávání a opakované běhy. Výsledky druhého experimentu je tedy podle autorů třeba brát jako ukázku chování, nikoli jako žebříček.
Případová studie Hermes ToolPerf
Případová studie Hermes ToolPerf porovnala základní a opravené revize na devíti úlohách. Každá úloha běžela třikrát na model a variantu. Dohromady tak vzniklo 108 běhů. Po celou dobu zůstaly stejné prompty, nástroje, limity provádění i kontroly úspěchu. Studie tedy porovnává dvě varianty za shodných podmínek, které autoři popisují.
Čísla u dvou modelů
U modelu Qwen3 Coder 30B vzrostla úspěšnost z 19 z 27 běhů na 22 z 27. Model tedy dokončil o tři úlohy víc, ale autoři uvádějí, že pracoval víc. Průměrný počet volání LLM stoupl z 3,8 na 4,9. Volání nástrojů přibylo v průměru z 2,8 na 3,9. V obou případech jde o nárůst o 1,1 volání. Objem dat vzrostl z 16 KB na 33 KB a doba trvání z 27 na 42 sekund. U modelu Claude Sonnet 4.5 se výsledek podle textu prakticky nezměnil. Na základní revizi dokončil 24 z 27 běhů, u oprav 23 z 27, rozdíl tedy činí jeden běh.
Co stopy podle autorů ukázaly
Autoři z těchto záznamů vyvozují dvě věci. Podle nich byly Qwenovy navíc provedené tahy zotavením, nikoli chaotickým blouděním. Regrese v jedné úloze s vyhledáváním nezávislým na velikosti písmen souvisela s konkrétním výstupem sondy. Samotný úspěch či neúspěch úloh by podle autorů k takovému závěru nestačil. Jde o výklad autorů, který text opírá o stopy běhů, nikoli o samotná skóre.
Shrnutí hlavních bodů
Z popsaných ukázek vyplývá několik konkrétních bodů, které autoři uvádějí. Požadavek na nástroj v ATIF neříká nic o výsledku, a proto se skutečný průběh ověřuje v ATOF. První experiment používá pevný výstup VALUE=42 jako přesnou kontrolu úspěchu. Druhý experiment zobrazuje běh v nástroji Arize Phoenix a kontroluje, zda Hermes určil COLT 2026 jako název konference. Případová studie Hermes ToolPerf zahrnuje 108 běhů na devíti úlohách. U modelu Qwen3 Coder 30B vzrostla úspěšnost o tři běhy, ale vzrostly také počet volání, objem dat i doba trvání. U modelu Claude Sonnet 4.5 se výsledek prakticky nezměnil.
Jak číst uvedené údaje
Z uvedených tvrzení nevyplývá, že by nástroj sám zaručoval lepší výsledky agentů. Text popisuje, co stopy ukázaly v konkrétních ukázkách. Tvrzení o případové studii pocházejí od autorů textu. Druhý experiment neslouží k řazení modelů a ukázkové počty tokenů a identifikátory se mezi běhy mohou lišit. Při čtení čísel je proto vhodné držet se toho, co autoři výslovně uvádějí.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Tracing Agent Harness Behavior with NVIDIA NeMo Relay | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.