
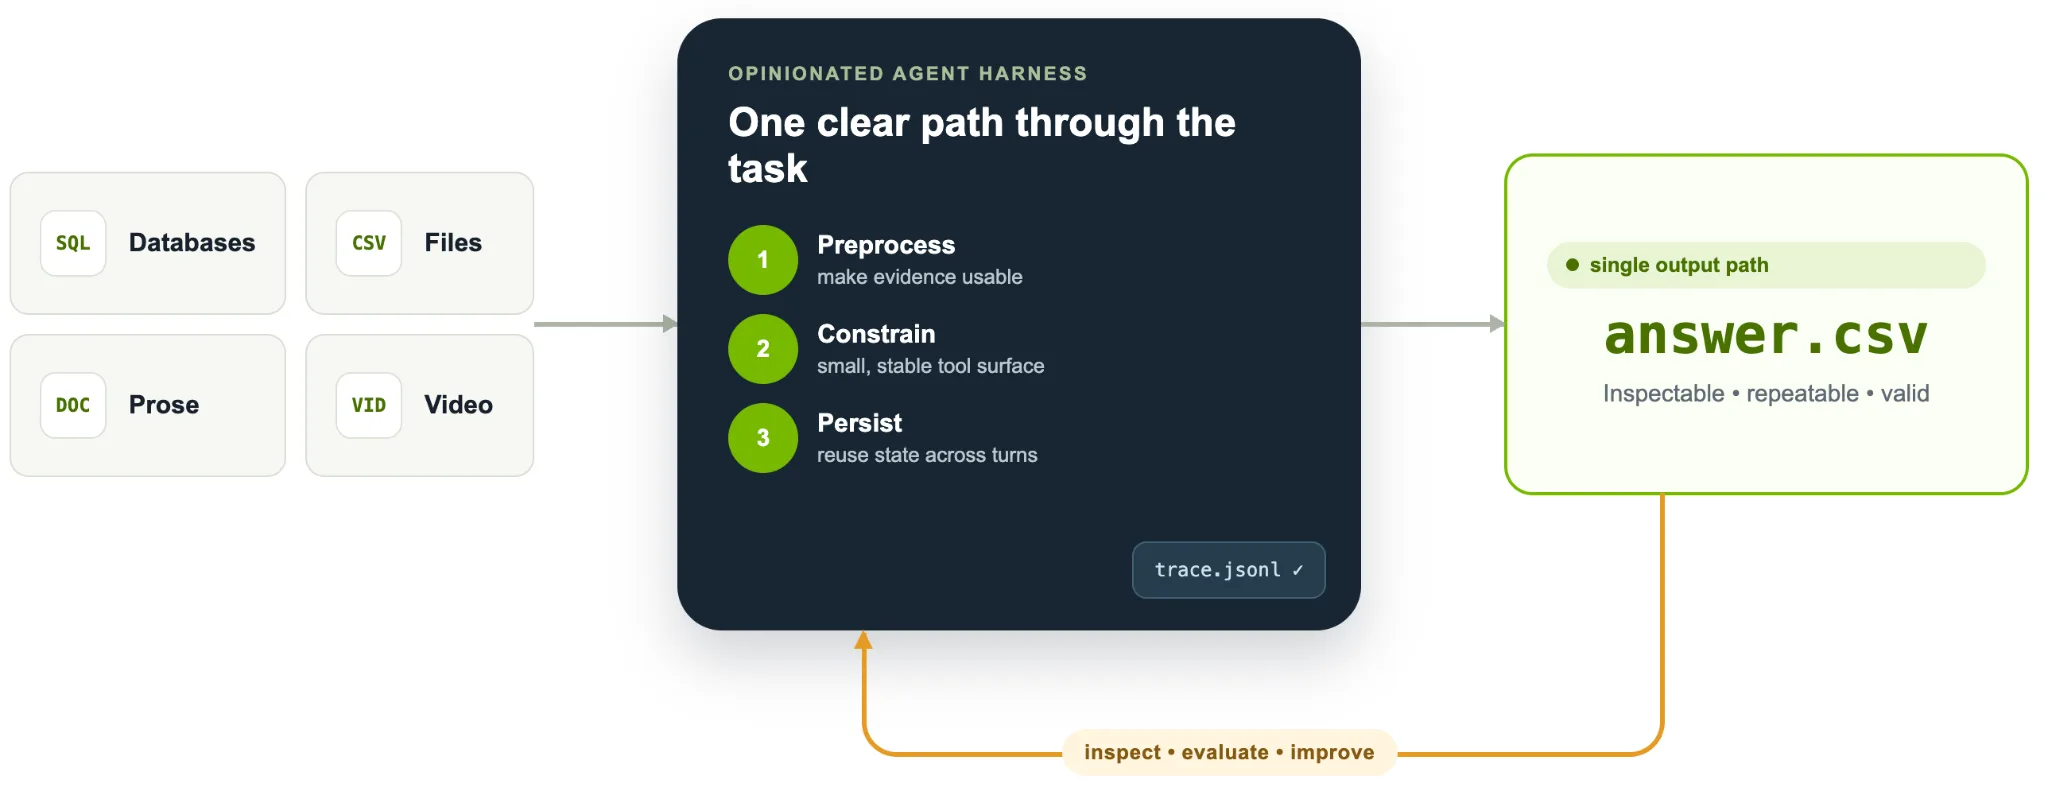
Tým NVIDIA KGMON obsadil druhé místo v soutěži KDD Cup 2026 Data Agents. Jeho systém vycházel z jednoduché myšlenky: udělat takzvaný harness, tedy okolní prostředí agenta, menší, přehlednější a snáze ověřitelný.
Pravidla soutěže vyžadovala práci s malým a pevně daným velkým jazykovým modelem, takže hlavní optimalizovatelnou částí byl právě harness. Tým se proto snažil úlohu pro dostupný model zjednodušit. K tomu využil předzpracování dat, omezené nástroje, trvalý stav a systematickou evaluaci.
Optimalizace práce se strukturovanými daty
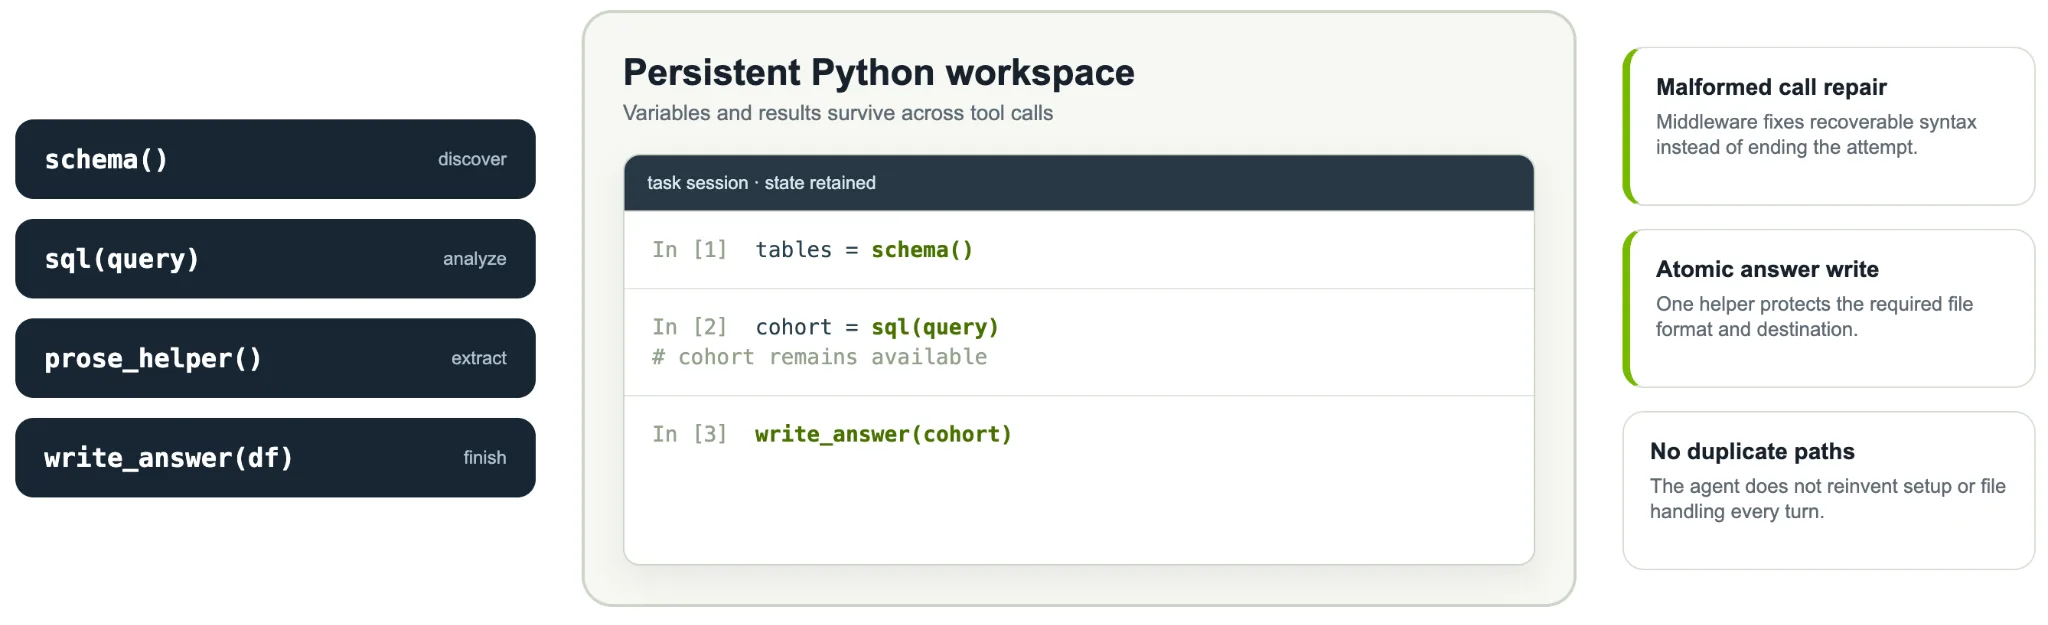
Optimalizace práce se strukturovanými daty začala u týmu KGMON sjednocením dostupných informací. Původně rozdělené soubory ve formátech CSV a JSON převedli do tabulek v rámci jedné databáze SQLite. Díky tomuto kroku získal agent jednotné SQL rozhraní pro přístup ke všem strukturovaným datům, které bylo realizováno pomocí funkcí schema() a sql(query). Tento přístup umožnil agentovi efektivněji komunikovat s daty bez nutnosti přepínat mezi různými typy souborů a formáty. Převod do SQLite databáze umožnil agentovi využívat standardizovaný SQL jazyk, což je pro LLM mnohem přirozetější a méně chybové než manipulace s různými formáty souborů, kde by musel pracovat s různými knihovnami pro čtení CSV či JSON. Funkce schema() poskytovala modelu přehled o struktuře tabulek a jejich vztazích, zatímco sql(query) umožňovala přímé provádění dotazů a získávání výsledků v tabulkovém formátu, což dramaticky zjednodušilo proces extrakce konkrétních datových hodnot.
Zavedení jediného SQL rozhraní přineslo podle autorů konkrétní přínosy v podobě snížení chyb při výběru zdroje dat a omezení zbytečných tahů v rámci procesu. Tímto zjednodušením získal fixní model více prostoru pro samotné uvažování nad daty, místo aby spotřebovával kapacitu řešením problémů s navigací v datech. Celý systém byl doplněn o specifické funkce pro správu schématu a zápis odpovědí, což pomohlo minimalizovat syntaktické chyby a chyby při manipulaci se soubory.
Efektivní zpracování textových dokumentů
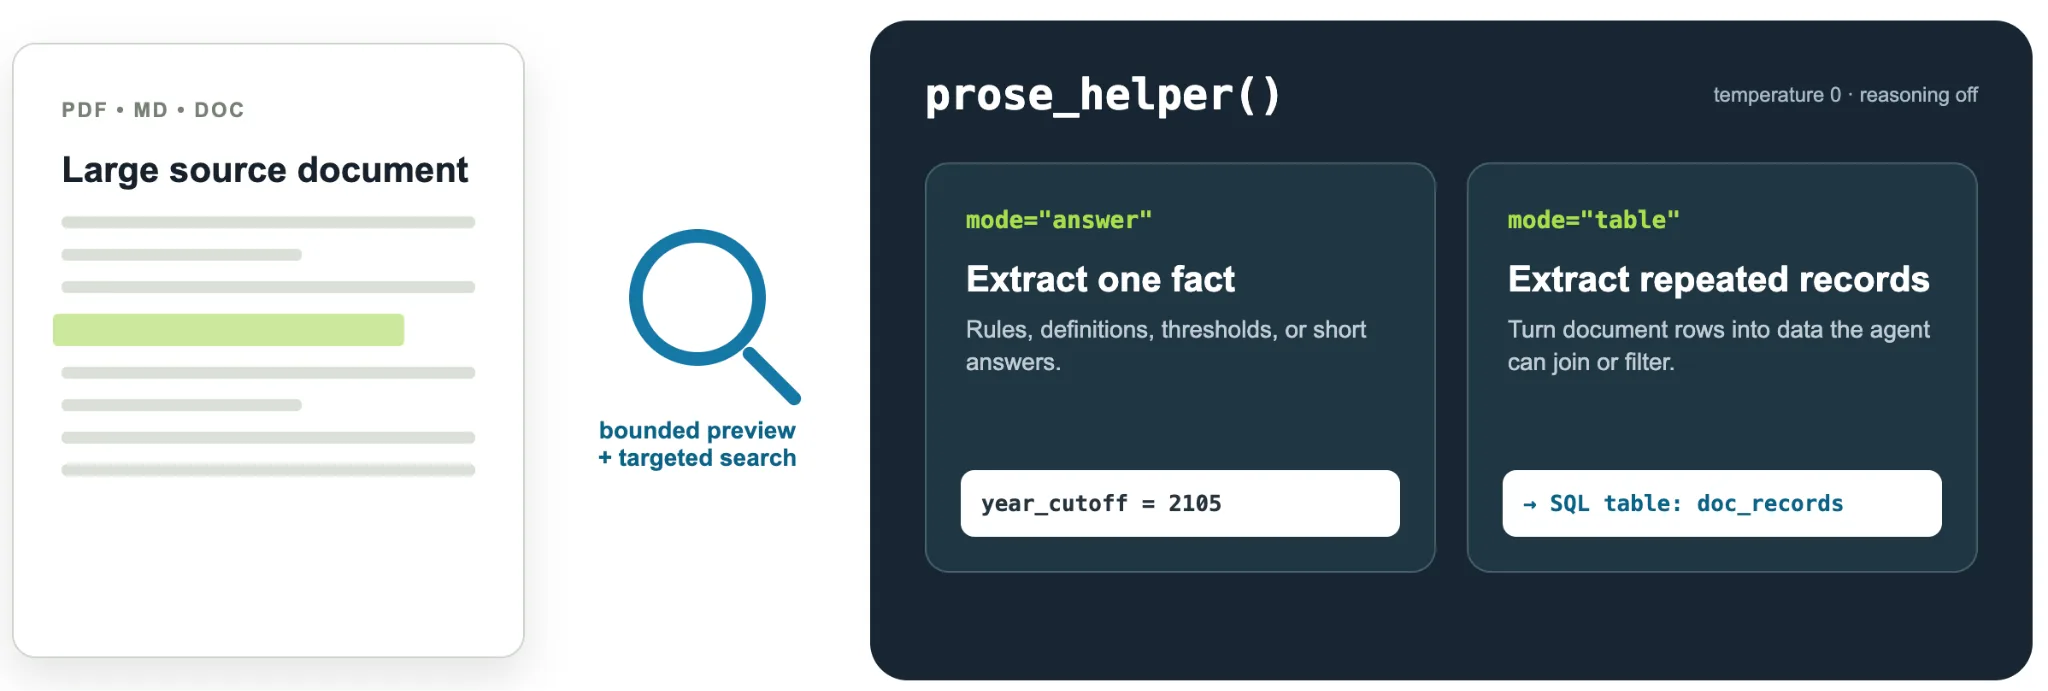
Efektivní zpracování textových dokumentů tým KGMON vyřešil tak, že agentovi zablokoval přímé čtení celých souborů. Agent mohl s dokumenty pracovat jen prostřednictvím omezených náhledů a vyhledávání podle počtu znaků nebo regulárních výrazů. Po nalezení relevantní části mohl využít nástroj prose_helper, který předal úseky dokumentu samostatnému volání LLM s nulovou teplotou a vypnutým uvažováním. Nástroj vracel odpovědi nebo vytěžené tabulky, takže surový obsah dokumentů nezatěžoval kontext hlavního agenta.
K nalezeným relevantním částem textu poté přistupoval speciální nástroj prose_helper. Tento pomocník předával vybrané úseky dokumentů samostatnému volání velkého jazykového modelu s nulovou teplotou, což zaručuje konzistentnější výstupy. Nástroj vracel pouze konkrétní odpovědi nebo extrahované tabulky, čímž udržel surový text mimo kontext hlavního agenta. Vizuální schéma znázornuje, jak prose_helper funguje v režimu odpovědí pro extrakci faktů nebo v režimu tabulek pro převod záznamů do formátu SQL. Klíčovým aspektem nástroje prose_helper bylo nastavení teploty (temperature) na nulu, což v praxi znamená odstranění náhody z generování textu a zajištění, aby stejný vstup vždy vedl k identické odpovědi. Tímto způsobem byl prose_helper izolován od hlavního agenta; fungoval jako specializovaný extraktor, který z surového textu vytěžil pouze fakta nebo strukturované tabulky. Tímto mechanismem se předešlo situaci, kdy by hlavní agent byl zahlcen irelevantními detaily z dokumentů a ztratil nit u hlavního analytického úkolu.
Analýza chyb a iterativní vylepšování
Analýza chyb a iterativní vylepšování začínalo u podrobného zaznamenávání každého kroku procesu. Systém evidoval prompty, volání nástrojů, SQL dotazy, mezivýsledky i chyby. Specializovaný inspekční agent pak mohl neúspěšné trajektorie kategorizovat a upozorňovat na opakující se problémy, což týmu pomáhalo určovat priority zlepšení. Záznamy ukázaly, zda chyba vznikla kvůli matoucímu schématu, nesprávnému spojení tabulek, přehlédnutému textu, formátu výstupu, nebo křehkému pravidlu v promptu.
Pro zvýšení spolehlivosti autoři využili opakované pokusy, které seskupovali podle hodnoty odpovědí namísto názvů sloupců. U sporných úloh bylo možné přidat další běhy, což pomohlo odlišit stabilní odpovědi od ojedinělých chyb. Opakované pokusy ale zvyšují spotřebu tokenů, latenci i náklady na výpočet. Autoři proto doporučují používat ensembling v produkci selektivně, jen u úloh, jejichž hodnota, nejistota nebo riziko tyto náklady ospravedlňují.
Kritický pohled a implementace do praxe
Kritický pohled a implementace do praxe vyžadují opatrnost při přejímání metod z experimentálních prostředí. Autoři zdůrazňují, že konkrétní řešení vyvinuté pro KDD Cup bylo zásadně utvářeno specifickými podmínkami daného benchmarku. Mezi tyto faktory patřil například fakt, že systém pracoval s pevně daným modelem, neměl přístup k internetu a musel zvládat různorodé balíky úloh. Důležitý vliv mělo také hodnocení zaměřené na úroveň hodnot a dostupný dlouhý časový rozpočet pro dokončení úkolů. Dlouhý časový rozpočet pro dokončení úkolů v rámci soutěže umožnil implementaci vícefázového ověřování a opakovaných pokusů, což by v interaktivním systému pro koncové uživatele, kde se očekává odpověď během sekund, nebylo možné. Absence přístupu k internetu rovněž znamenala, že agent musel být zcela autonomní v rámci poskytnutých dat a nemohl využívat externí znalostní báze, což posunulo důraz na precizní manipulaci s lokálními daty v SQLite a textovými dokumenty.
Právě tato specifika znamenají, že ne každé designové rozhodnutí zadané v rámci soutěže by mělo být přímo přeneseno do reálné produkce. Zatímco v kontrolovaném prostředí benchmarku mohou být určité přístupy efektivní, v praktickém nasazení mohou narazit na jiné limity nebo požadavky na efektivitu. Je proto nezbytné rozlišovat mezi optimalizací pro maximalizaci skóre v testu a tvorbou robustního nástroje pro každodenní provoz, kde jsou priority často odlišné od těch stanovených v rámci akademických nebo soutěžních rámců.
Grafy a schéma pocházejí z původního článku uvedeného ve zdrojích.
Zdroje
- Building Reliable Data Analytics Agents: Lessons from the KDD Cup | NVIDIA Technical Blog — NVIDIA Developer Blog
Článek vznikl s pomocí AI; podklady a odkazy jsou uvedeny výše.